从噪声到图像的一条连续河流:Flow Matching 与 DiT 深入浅出
扩散模型最常见的叙事是:先把图像逐渐加噪,再训练网络逆转这个过程。Flow Matching 换了一个更几何的视角:
在噪声分布与数据分布之间铺一条随时间变化的概率路径,再学习一个速度场,把整团概率质量沿这条路径运过去。
这句话里其实藏着两层完全不同的问题:
- 动力学怎么定义?也就是概率路径、速度场、训练目标与 ODE 求解器。这是 Flow Matching 关心的事。
- 速度场由谁计算?可以是 U-Net、MLP,也可以是 Transformer。图像领域里,DiT 是目前最重要的参数化方式之一。
因此,Flow Matching 和 DiT 不是竞争关系,也不是同一个概念。前者更像“训练与生成的物理定律”,后者更像“实现局部速度预测的计算引擎”。现代文生图模型把二者组合起来,是因为它们恰好分别解决了生成动力学与可扩展网络架构的问题。
读完本文,你应该能回答:
- 连续性方程为什么是 Flow Matching 的数学地基?
- 不知道边缘速度场时,为什么回归条件速度仍然正确?
- 直线插值为什么不保证实际 ODE 轨迹是直线?
- Flow Matching、Rectified Flow、扩散模型与 CNF 到底是什么关系?
- DiT 怎样把二维潜变量变成 token,又怎样注入时间和文本条件?
- adaLN-Zero 为什么看似只是一个初始化技巧,却对 DiT 很关键?
- 训练为何不需要解 ODE,而采样仍然需要?
- 时间采样、耦合、CFG、ODE solver 和 VAE 各自会在哪里制造误差?
一、先把全景图放在桌上
一个典型的 latent Flow Matching + DiT 图像生成系统可以拆成五件东西:
| 层次 | 数学或工程对象 | 它负责什么 |
|---|---|---|
| 数据表示 | VAE / Autoencoder | 把高维像素压缩为较小的连续潜变量 |
| 概率路径 | $p_t,\ t\in[0,1]$ | 规定噪声分布怎样连续过渡到数据分布 |
| 学习目标 | Flow Matching loss | 教网络在任意 $(x,t)$ 预测局部速度 |
| 速度网络 | DiT / MMDiT | 用 Transformer 处理潜变量 patch、时间和文本条件 |
| 数值积分 | Euler、Heun、Runge–Kutta 等 | 从随机噪声出发,多次查询速度网络,积分到生成样本 |
这张图也解释了一个常见误称:DiT 不必然是“扩散损失”,Flow Matching 也不必然使用 Transformer。原始 DiT 用扩散目标训练;后来 SiT、Stable Diffusion 3、FLUX 等工作则展示了 flow / rectified-flow 类目标与 Transformer 骨干的组合。
下面先暂时忘掉图像和 Transformer,只研究一个更纯粹的问题:怎样把一种分布连续搬成另一种分布。
二、从单个粒子的 ODE 到整团概率的连续性方程
1. 一个样本怎样移动
设源分布为 $p_0$,通常取标准高斯;目标数据分布为 $p_1$。本文统一采用:
\[t=0\ \text{表示噪声},\qquad t=1\ \text{表示数据}.\]有些扩散论文使用相反方向,读公式时第一件事应检查时间约定。
现在定义一个随时间变化的向量场:
\[v_t:\mathbb{R}^d\rightarrow\mathbb{R}^d.\]它告诉位于 $x$ 的粒子,在时刻 $t$ 应该往哪个方向、以多快的速度移动。单个粒子的轨迹满足常微分方程:
\[\frac{\mathrm d x_t}{\mathrm d t}=v_t(x_t),\qquad x_0\sim p_0.\]如果 $v_t$ 足够光滑,解 ODE 会得到一族映射 $\phi_t$,使得 $x_t=\phi_t(x_0)$。我们的目标是让终点分布满足:
\[(\phi_1)_\#p_0=p_1,\]其中 $#$ 表示 push-forward:不是把某一个噪声点变成“与它配对”的某张训练图,而是把整团概率质量变成目标分布。
2. 一团概率怎样守恒
单个粒子遵守 ODE,粒子群的密度则遵守连续性方程:
\[\partial_t p_t(x)+\nabla\cdot\bigl(p_t(x)v_t(x)\bigr)=0.\]它就是概率版本的质量守恒:
- 某处密度增加,是因为净概率流入;
- 某处密度减少,是因为净概率流出;
- 概率不会凭空产生或消失。
一维情况下更容易看清。若速度恒为正且右侧流出量大于左侧流入量,该小区间里的密度就会下降。高维里的散度 $\nabla\cdot(p_tv_t)$ 正是“净流出率”。
这条方程是 Flow Matching 的核心判据:只要我们找到一个与预定 $p_t$ 相容的速度场,沿 ODE 推进就能得到同一族边缘分布。
3. 它为什么也是 Continuous Normalizing Flow
沿着某条 ODE 轨迹,瞬时对数密度变化为:
\[\frac{\mathrm d}{\mathrm dt}\log p_t(x_t) =-\nabla\cdot v_t(x_t).\]积分它就能计算连续归一化流(Continuous Normalizing Flow,CNF)的似然。与早期逐层可逆的 normalizing flow 相比,CNF 不要求每一层都手工设计易求行列式的可逆变换,而把可逆性放在 ODE 流上。
但“理论上可算似然”不等于“训练文生图时会去算似然”。高维散度代价不低,现代大规模 Flow Matching 常用速度回归训练;若研究重点是感知质量,通常不会在每个训练步显式积分散度。
三、看起来不可能的 Flow Matching 目标
假设我们已经选定一条概率路径 $p_t$,并知道与它相容的真实边缘速度场 $u_t(x)$,最直接的回归目标是:
\[\mathcal L_{\mathrm{FM}}(\theta) = \mathbb E_{t\sim U[0,1],\,x\sim p_t} \left[ \left\|v_\theta(x,t)-u_t(x)\right\|^2 \right].\]问题立刻出现了:$p_t$ 往往只是“所有训练样本对应路径的混合”,其密度和边缘速度都没有闭式形式。为了生成一个监督样本,难道先要解出本来就想学习的全局运输问题?
Flow Matching 最漂亮的一步,就是把不可得的边缘对象换成可采样的条件对象。
四、关键魔术:Conditional Flow Matching
1. 先把复杂路径拆成简单小桥
引入一个条件变量 $z$。它可以是一张数据图,也可以是一对噪声—数据样本。为每个 $z$ 定义:
- 容易采样的条件路径 $p_t(x\mid z)$;
- 容易计算的条件速度 $u_t(x\mid z)$。
把所有条件路径混合起来,就得到边缘路径:
\[p_t(x)=\int p_t(x\mid z)q(z)\,\mathrm dz.\]对应的边缘速度是条件速度的后验平均:
\[u_t(x) = \int u_t(x\mid z) \frac{p_t(x\mid z)q(z)}{p_t(x)} \,\mathrm dz = \mathbb E\!\left[u_t(X_t\mid Z)\mid X_t=x\right].\]这个式子很重要:在同一个 $(x,t)$,许多条件小桥可能给出不同方向;真正的边缘速度场取它们在“已知粒子来到这里”条件下的平均。
于是可以训练:
\[\mathcal L_{\mathrm{CFM}}(\theta) = \mathbb E_{t,z,x\sim p_t(\cdot\mid z)} \left[ \left\|v_\theta(x,t)-u_t(x\mid z)\right\|^2 \right].\]平方损失的总体最优解正是条件均值。更严格地说,在常见正则条件下,
\[\nabla_\theta\mathcal L_{\mathrm{CFM}} = \nabla_\theta\mathcal L_{\mathrm{FM}},\]两者只相差一个与 $\theta$ 无关的常数。因此我们不必显式知道 $u_t(x)$,只要能不断抽到便宜的条件监督,就能学到同一个边缘速度场。
2. 最简单的直线随机插值
取一份噪声 $x_0\sim p_0$ 和一份数据 $x_1\sim p_1$,定义:
\[x_t=(1-t)x_0+t x_1.\]对固定样本对 $(x_0,x_1)$,这是一条直线,条件速度更简单:
\[\dot x_t=x_1-x_0.\]训练只需四步:
- 抽 $x_0,x_1$;
- 抽 $t$;
- 构造 $x_t$;
- 让网络回归 $x_1-x_0$。
不必沿轨迹从 0 积分到 $t$,也不必先运行一次扩散链。这就是论文所说的 simulation-free training。注意它只描述训练:生成时仍要积分学到的 ODE。
3. 条件直线,不等于模型轨迹是直线
这是理解 Flow Matching 的分水岭。
如果噪声与数据独立配对,许多线段会在高维空间交叉或互相穿插。模型看到相同的 $(x,t)$ 时并不知道这次来自哪一对端点,只能输出一个速度。这个局部平均通常会产生弯曲的积分曲线。
因此应区分三种对象:
- 条件插值线:人为定义,负责制造训练样本;
- 边缘速度场:条件速度在给定 $(x,t)$ 后的平均;
- ODE 轨迹:采样时沿边缘速度场积分出来的路径。
只有在耦合很好、条件速度歧义很小等情形下,后两者才会接近条件直线。
4. 为什么模型不会只学到“所有图像的均值”
在 $t=0$ 附近,如果 $x_0$ 与 $x_1$ 独立,给定某个噪声点后,对数据端的条件不确定性确实很大,最优瞬时方向含有“朝总体均值走”的成分。但生成不是一次性回归 $x_1$:
- 相邻噪声点并不完全相同;
- 速度场随位置和时间变化;
- 进入中间时刻后,当前状态会携带越来越多关于未来模态的信息;
- 整个分布由 ODE 的可逆流共同推进。
所以不能把 Flow Matching loss 当成普通的“噪声输入 $\to$ 图像 MSE”。后者只有一次映射,容易平均化;前者监督的是全时域的局部向量场。
五、路径、参数化与耦合:三个经常被混在一起的旋钮
1. 不只有直线路径
常见的高斯概率路径可写成:
\[x_t=\alpha_t x_1+\sigma_t\epsilon,\qquad \epsilon\sim\mathcal N(0,I).\]其条件速度目标是:
\[\dot x_t=\dot\alpha_t x_1+\dot\sigma_t\epsilon.\]线性插值只是 $\alpha_t=t,\ \sigma_t=1-t$ 的特例。也可以选扩散式的方差保持路径、方差爆炸路径或其他 stochastic interpolant。Flow Matching 是一套回归速度场的框架,并不要求路径必须是直线。
2. 预测 velocity、noise、score 还是 clean sample
同一个 $x_t=\alpha_t x_1+\sigma_t\epsilon$ 可以选择不同网络输出:
| 参数化 | 网络预测 | 常见直觉 |
|---|---|---|
| velocity | $\dot\alpha_t x_1+\dot\sigma_t\epsilon$ | 当前应该怎样移动 |
| noise | $\epsilon$ | 当前状态里有多少噪声 |
| clean / data | $x_1$ | 最终干净样本是什么 |
| score | $\nabla_x\log p_t(x)$ | 密度向哪里增长最快 |
在系数非退化时,它们可以相互换算。以线性路径为例:
\[v_t=x_1-\epsilon,\qquad x_1=x_t+(1-t)v_t,\qquad \epsilon=x_t-tv_t.\]但“可换算”不代表有限容量、有限精度和特定 loss weighting 下训练难度完全相同。不同参数化会重新分配各时间段的信号尺度与误差,因此工程比较必须固定路径、权重、时间采样和 sampler。
3. Coupling 决定谁与谁相连
仅规定端点边缘分布 $p_0,p_1$,并没有规定某个噪声应与哪张图配对。这种联合分布叫 coupling:
\[\pi(x_0,x_1),\qquad \pi_0=p_0,\ \pi_1=p_1.\]最简单的是独立耦合 $p_0p_1$,实现便宜,但线段可能大量交叉。mini-batch optimal transport 会在一个 batch 内寻找运输成本较小的配对,通常降低条件速度的方差,让边缘流更容易学、轨迹也可能更直。
这里要克制两种过度表述:
- mini-batch OT 只是全局 OT 的近似,质量受 batch 大小、代价函数和特征空间影响;
- 欧氏空间里的短距离不一定等于感知语义上的好耦合,尤其在经过 VAE 压缩的潜空间中。
4. Flow Matching 与 Rectified Flow 不是严格同义词
二者历史上独立发展、数学重叠很大,但最好保留概念边界:
- Flow Matching:强调给定概率路径后,通过条件速度回归学习 CNF;可以使用扩散路径、OT 路径或其他路径。
- Rectified Flow:强调学习连接两端分布的 ODE,并通过重新耦合 / reflow 等方式让运输轨迹更直、更适合粗步长积分。
今天很多工程代码把线性插值 + velocity regression 直接称为 rectified flow,也有人称为 OT-CFM 或 flow matching。只看名称容易争论不休;阅读实现时应直接检查四样东西:$\alpha_t,\sigma_t$、端点方向、coupling、loss target。
六、训练很便宜,采样为什么仍然要解 ODE
1. 最小训练伪代码
下面是潜空间线性 Flow Matching 的骨架。真实系统还会加入时间权重、条件 dropout、latent scaling、混合精度和 EMA。
def flow_matching_loss(model, z_data, condition):
    z_noise = torch.randn_like(z_data)
    t = torch.rand(z_data.shape[0], device=z_data.device)
    t_view = t.view(-1, 1, 1, 1)

    z_t = (1 - t_view) * z_noise + t_view * z_data
    target_velocity = z_data - z_noise
    predicted_velocity = model(z_t, t, condition)

    return (predicted_velocity - target_velocity).square().mean()
每个 batch 只随机抽一个或若干 $t$,这让训练像普通监督学习一样并行。这里的“无需模拟”是相对于需要先求完整轨迹或逐步反演的训练方案而言,并不是说没有随机过程或数值问题。
2. 最小 Euler 采样
生成时只知道初始噪声,不知道终点 $x_1$,所以必须沿学到的场前进:
z = torch.randn(shape, device=device)
grid = torch.linspace(0.0, 1.0, steps + 1, device=device)

for t0, t1 in zip(grid[:-1], grid[1:]):
    dt = t1 - t0
    velocity = model(z, t0.expand(batch_size), condition)
    z = z + dt * velocity

image = vae.decode(z)
Euler 每步一次网络评估,一阶误差;Heun 会先预测终点速度,再用起点与预测终点的平均速度修正:
\[\tilde x_{n+1}=x_n+h\,v(x_n,t_n),\] \[x_{n+1} = x_n+\frac h2 \left[ v(x_n,t_n)+v(\tilde x_{n+1},t_{n+1}) \right].\]Heun 每步通常需要两次网络评估,所以比较速度时应使用 NFE(number of function evaluations),而不能只报“20 步”。
3. 路径越直,为什么往往越容易少步
Euler 本质上用当前切线代替未来一小段曲线。局部截断误差与轨迹的高阶导数有关;若速度方向快速改变,粗步长就会切弯道。更直、更平滑、非刚性的路径通常允许更大的步长。
但“straight is fast”仍需加限定:
- 速度大小可能在端点爆炸;
- 时间参数化可能让某个窄区间承担大部分变化;
- CFG 会把条件场与无条件场外推,显著增加曲率;
- VAE 潜空间的欧氏直线不一定对应像素或语义空间的直线;
- 网络逼近误差与数值积分误差是两类不同误差。
所以少步结果必须报告 sampler、时间网格、NFE、CFG scale、分辨率和模型版本。
七、DiT:把“预测速度”交给 Transformer
1. 为什么不直接在像素上做 Transformer
一张 $256\times256$ RGB 图像有 196,608 个标量。若逐像素或按很小 patch 做全局 self-attention,token 数过大。原始 DiT 沿用 latent diffusion:
\[x\ \xrightarrow{\text{VAE encoder}}\ z.\]假设 VAE 空间下采样 8 倍,$256\times256$ 图像会变成约 $32\times32\times C$ 的潜变量。若 latent patch size 为 $p=2$,token 数是:
\[N=\frac{32}{2}\times\frac{32}{2}=256.\]然后每个 $2\times2\times C$ patch 经线性投影变成一个 $d$ 维 token,再加二维位置编码。这与 ViT 的 patchify 很像,只是输入不是 RGB,而是带噪潜变量 $z_t$。
2. “XL/2”里的 2 不是两层
DiT-S、B、L、XL 表示不同深度和宽度;斜杠后的 2、4、8 是 latent patch size。patch 越小:
- token 越多;
- 空间细节保留得越细;
- self-attention 和 MLP 计算越贵。
把 patch size 从 4 减到 2,二维 token 数变为 4 倍,注意力矩阵元素数变为 16 倍;总 GFLOPs 不一定恰好 16 倍,因为线性层、MLP 等项也占成本。原始项目测试的 S 到 XL 约为 33M 到 675M 参数,最高计算配置 DiT-XL/2 在 $256^2$ 设置约 119 GFLOPs。
论文最有价值的经验不是“Transformer 一定胜过 U-Net”,而是:在其训练与评测设置中,随着深度、宽度或 token 数带来的前向 GFLOPs 增长,FID 呈稳定改善;相同参数量下,patch size 造成的计算差异也能显著改变效果。扩展的关键变量更接近有效计算,而不只是参数数目。
3. 时间条件怎样进入 Transformer
普通 ViT 只接收图像 token,生成模型还必须知道:
- 当前时间 $t$;
- 类别或文本条件 $c$;
- 有时还包括分辨率、裁剪位置、长宽比、相机或其他模态条件。
原始 DiT 将 $t$ 先做正弦频率嵌入,再经 MLP;类别标签查 embedding。二者相加得到条件向量 $c$。论文比较了四种注入方式:
- 把条件 token 拼进序列;
- 使用 cross-attention;
- adaptive LayerNorm(adaLN);
- adaLN-Zero。
最终 adaLN-Zero 在其设计空间中表现最好,而且额外计算很小。
4. adaLN-Zero 到底做了什么
标准 Transformer block 可以粗写成:
\[x\leftarrow x+\operatorname{Attention}(\operatorname{LN}(x)),\] \[x\leftarrow x+\operatorname{MLP}(\operatorname{LN}(x)).\]adaLN 根据时间与类别条件,生成每个通道的 shift、scale 和 residual gate。原始实现一次产生六组向量:
\[(\beta_{\mathrm{attn}},\alpha_{\mathrm{attn}},\gamma_{\mathrm{attn}}, \beta_{\mathrm{mlp}},\alpha_{\mathrm{mlp}},\gamma_{\mathrm{mlp}}).\]每个子层类似:
\[x\leftarrow x+ \gamma_{\mathrm{attn}}\odot \operatorname{Attention} \left( (1+\alpha_{\mathrm{attn}})\odot\operatorname{LN}(x) +\beta_{\mathrm{attn}} \right).\]关键在 Zero:产生调制量的最后一层线性层初始化为零,输出层也做零初始化。训练刚开始时,$\gamma\approx0$,每个残差块近似恒等映射。
这带来两个直觉上的好处:
- 深网络初始不会让随机残差分支破坏输入;
- 条件控制从零逐渐长出来,优化器可以学习每个 block 在什么时间、对什么条件打开多少。
它不是一般意义上的“LayerNorm 参数设为零”,也不是把整个 Transformer 权重清零;被零初始化的是条件调制与最终输出的特定层。
5. 输出头预测什么
Transformer 输出仍是一串 token,需要线性投影回 $p\times p\times C_{\text{out}}$,再 unpatchify 成与 $z_t$ 同样的空间布局。
原始 DiT 配合扩散目标时可同时预测噪声相关量与对角协方差,因此开启 learn_sigma 时输出通道为输入通道的两倍。若改为最简单的 Flow Matching velocity objective,输出通常只需与潜变量相同的 $C$ 个速度通道。
因此从原始 DiT 迁移到 Flow Matching,不能只替换 sampler 名称,还要核对输出通道、preconditioning、time embedding、loss target 与 checkpoint 的训练约定。
八、真实的 DiT 生成样例,以及它证明不了什么
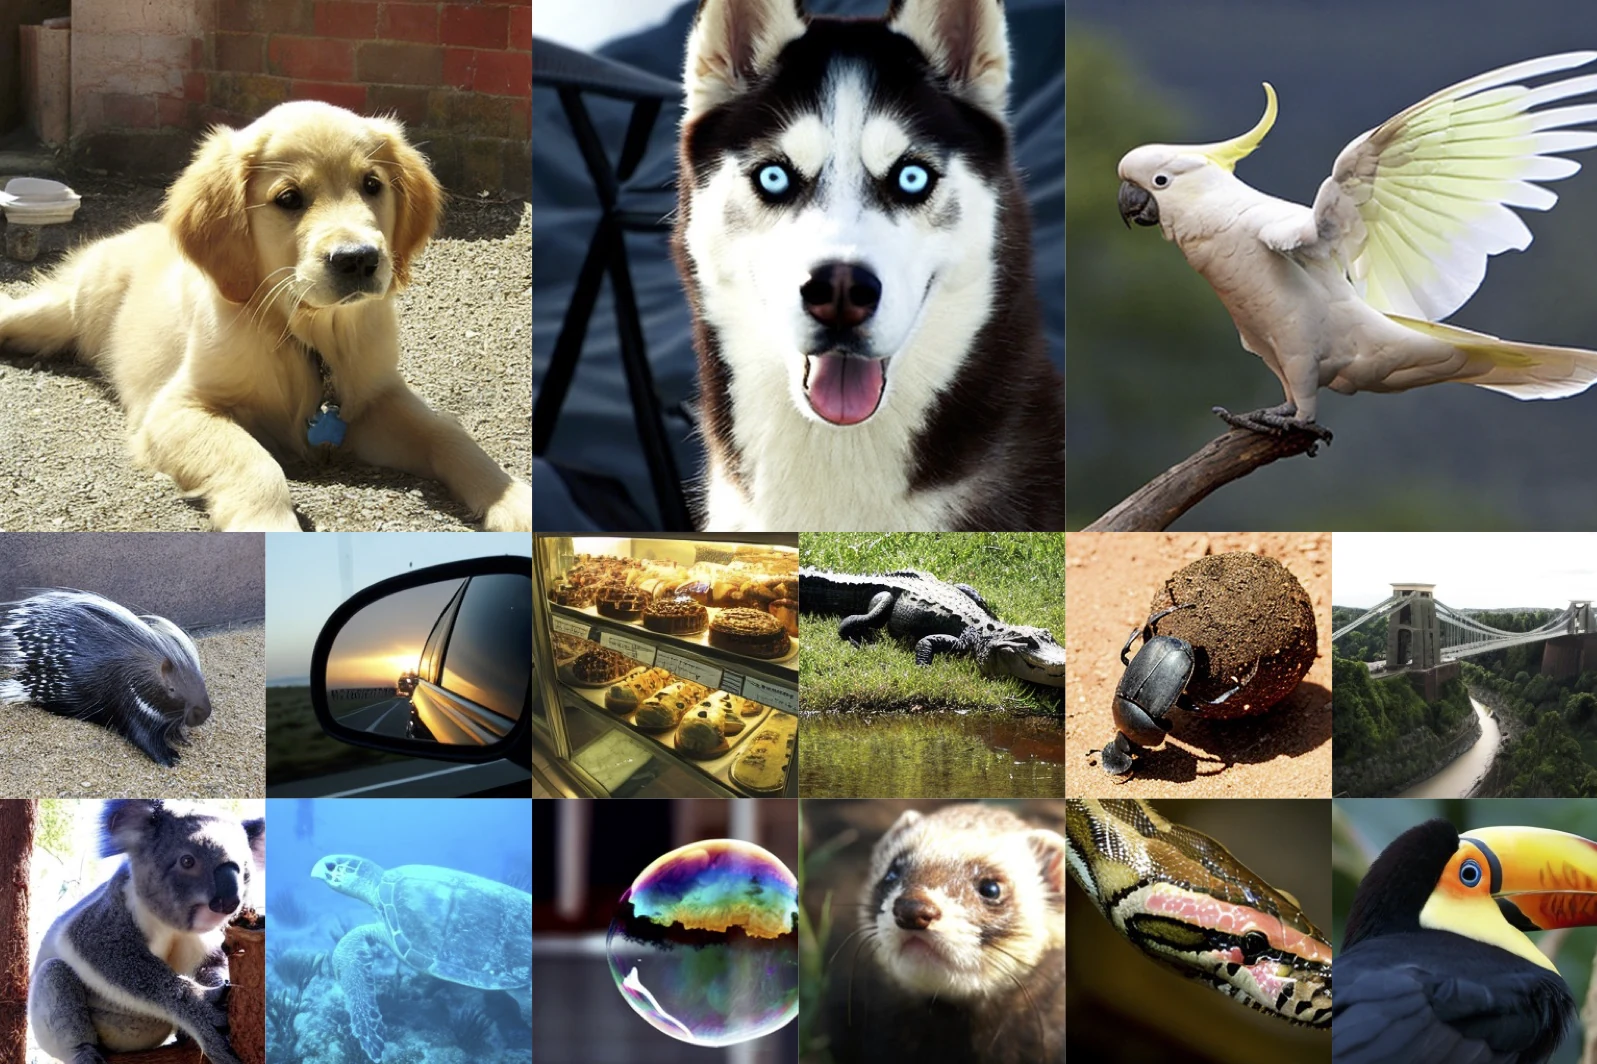
原始 DiT 论文在 ImageNet 类别条件生成上报告:DiT-XL/2 在 $256\times256$、使用 classifier-free guidance 的设置达到 FID-50K 2.27;在 $512\times512$ 达到 3.04。它展示了 Transformer 作为 latent diffusion backbone 的可扩展性。
但一张精选样例网格不能证明:
- 模型覆盖了全部数据分布;
- 没有记忆训练样本;
- FID 足以代表文本遵循、组合性或人类偏好;
- Flow Matching 优于扩散,因为原始 DiT 本身使用的是扩散训练目标;
- 后来的任意 DiT 模型都会复现相同结果。
真实图片应该帮助读者理解模型能生成什么,也要配合数据集、采样设置和总体指标阅读。精选样图是定性证据,不是统计结论。
九、把 Flow Matching 与 DiT 真正接起来
现在可以把训练写成一条完整的数据流:
- 图像 $x$ 经冻结或共同训练的 autoencoder 得到 $z_1$;
- 采样 $z_0\sim\mathcal N(0,I)$、时间 $t$ 和文本条件 $c$;
- 按选定概率路径构造 $z_t$ 和监督速度 $u_t$;
- 将 $z_t$ patchify,送入 DiT;
- 用 time embedding 和文本表示调制 Transformer blocks;
- unpatchify 得到 $\hat v_\theta(z_t,t,c)$;
- 最小化加权速度回归误差;
- 推理时从 $z_0$ 出发,用 ODE solver 多次调用同一个 DiT;
- VAE decoder 把 $z_1$ 还原为图像。
训练目标可写为:
\[\mathcal L(\theta) = \mathbb E_{z_0,z_1,t,c} \left[ w(t)\left\| v_\theta(z_t,t,c)-\dot z_t \right\|^2 \right].\]这里的 $w(t)$、$t$ 的采样分布和 latent scaling 都不是无关紧要的实现细节。它们共同决定不同信噪比区域对梯度的贡献。
现代 MMDiT 为什么不再只是“把文本塞进 adaLN”
类别条件只有一个离散标签,文本却是一串 token。现代文生图架构通常希望图像 token 与文本 token 在多层中细粒度交互。
Stable Diffusion 3 提出的 MMDiT 为图像与语言表示保留不同的参数流,再让两种 token 在 joint attention 中交换信息。官方论文同时使用改进的 rectified-flow 训练,并通过偏置时间采样把更多训练预算放到感知上重要的噪声尺度。这里有两条相互独立的改进:
- MMDiT 改的是条件建模与网络结构;
- Rectified Flow / Flow Matching 类目标改的是概率路径和监督信号。
FLUX.1 官方模型卡同样把其描述为 12B 参数的 rectified flow transformer。它说明这套组合已经从 ImageNet 研究架构扩展到大规模文本生成系统;但“用了 Flow Matching + Transformer”仍不足以推出质量,数据、autoencoder、文本编码器、训练规模、guidance 与后训练都同样重要。
十、Classifier-Free Guidance 在速度场里做了什么
CFG 训练时随机丢弃条件,使同一个网络同时学到:
\[v_{\mathrm{cond}}(x,t,c),\qquad v_{\mathrm{uncond}}(x,t).\]推理时组合:
\[v_{\mathrm{cfg}} = v_{\mathrm{uncond}} +s\left(v_{\mathrm{cond}}-v_{\mathrm{uncond}}\right).\]$s=1$ 给出普通条件预测;$s>1$ 是沿“条件相对无条件的差”做外推。它往往提高提示词对齐和局部清晰度,但也可能:
- 降低多样性;
- 造成饱和、过锐或结构伪影;
- 把速度场推到训练分布外;
- 增大轨迹曲率与 ODE 求解难度。
所以“无 CFG 时 20 NFE”和“CFG 7.5 时 20 NFE”不是相同数值问题。某些模型进一步训练 guidance-distilled 版本,把 CFG 行为蒸馏进一次网络预测,以降低每步两次条件分支的成本。
十一、博士生做实验时最容易踩的十个坑
1. 时间方向写反
训练用噪声 $\to$ 数据,scheduler 却按数据 $\to$ 噪声调用;或者公式来自相反约定却没有同时改 $\dot\alpha,\dot\sigma$。现象通常不是立刻报错,而是采样越走越像噪声。
2. 把 velocity parameterization 当成固定公式
不同 $\alpha_t,\sigma_t$ 下,velocity target 不同。扩散文献里的 $v$-prediction 与线性 Flow Matching 的 $x_1-x_0$ 也不应仅凭名字视为同一个张量。
3. 忽略 latent 的缩放常数
VAE 输出方差未必接近 1。训练时缩放、推理时未缩放,或者换 VAE 后沿用旧常数,都会改变信噪比与有效时间路径。
4. 只画条件直线判断“轨迹很直”
真正应该从固定初始噪声积分模型 ODE,再测速度方向变化、弧长 / 端点距离比或局部曲率。训练标签的线性不能替代采样轨迹诊断。
5. 把 batch OT 当成精确最优运输
不同 batch 会给出不同匹配,且图像 latent 的 L2 成本可能与语义无关。应报告 batch 大小、cost space、是否使用 Sinkhorn 及其正则强度。
6. 时间均匀采样却假定学习难度均匀
某些时段更难、梯度方差更大或对感知质量更关键。可以研究非均匀 $t$ sampling 与 $w(t)$,但二者会共同改变有效目标,消融时不能只换其中一个却沿用旧解释。
7. 只按 solver step 比较效率
Euler 一步通常 1 NFE,Heun 一步通常 2 NFE;CFG 还可能让一次“模型调用”包含条件与无条件分支。应同时报告 NFE、wall-clock、峰值显存与吞吐。
8. 训练损失下降就宣称生成质量提升
MSE 是向量场拟合误差,最终样本还经过长时间积分与 VAE 解码。至少应结合 FID / sFID、precision-recall、CLIP 类对齐指标、人评以及固定种子可视化。
9. DiT 加大参数,却不看 token 数
patch size、分辨率与 latent 下采样率会直接决定序列长度。对注意力而言,激活内存和通信可能比参数内存更早成为瓶颈。
10. 忘了数据空间与潜空间不是同一几何
Flow 在 latent 中的直线经过 decoder 后可能成为像素空间的复杂曲线。若 autoencoder 丢失小字、人脸或高频纹理,再强的 DiT 也只能在受损表示里建模。
十二、如何设计一组能回答问题的消融实验
如果研究目标是“为什么某个 Flow-DiT 更好”,建议按层拆解,而不是一次换掉整套 pipeline。
| 实验轴 | 至少固定什么 | 建议观察什么 |
|---|---|---|
| 路径 | 同一 DiT、数据、训练算力 | validation FM loss、轨迹曲率、FID 与 NFE 曲线 |
| coupling | 同一路径与 sampler | 条件速度方差、弧长比、训练稳定性 |
| 输出参数化 | 相同有效权重与时间分布 | 各时段梯度范数、端点误差、少步退化 |
| DiT 规模 | 同一 token 化与训练 tokens | loss–compute scaling,而非只看最终 FID |
| patch size | 尽量匹配参数量 | GFLOPs、激活显存、细节与全局一致性 |
| sampler | 同一 checkpoint 与 CFG | 质量–NFE–wall-clock Pareto 曲线 |
| CFG | 同一 solver / seed | 对齐、多样性、轨迹曲率和伪影 |
| autoencoder | 同一生成模型预算 | 重建上限、latent 统计与最终感知质量 |
一套尤其有解释力的诊断是:固定一批初始噪声,保存 0 到 1 的完整积分轨迹,同时记录
\[R_{\mathrm{arc}} = \frac{\sum_n\|x_{t_{n+1}}-x_{t_n}\|} {\|x_1-x_0\|},\]以及相邻速度的余弦相似度。$R_{\mathrm{arc}}=1$ 对应离散点严格共线;数值越大,路径绕行越多。但它只是几何指标,不保证感知质量,必须与样本指标联合报告。
十三、与扩散模型的关系:不是简单的“新方法替代旧方法”
扩散与 Flow Matching 有很大交集:
- 都可构造 $x_t=\alpha_t x_1+\sigma_t\epsilon$;
- 都能训练 time-conditioned neural network;
- score、noise、data 与 velocity 在适当条件下可换算;
- 扩散的 probability flow ODE 本身就是确定性连续流;
- stochastic interpolant 框架还能在 ODE 与带可调扩散项的 SDE 之间连接。
主要差别在于建模出发点:
- 经典 score-based diffusion 从前向 SDE / 加噪过程出发,学习 score,再反演 SDE 或 probability-flow ODE;
- Flow Matching 直接选概率路径,回归使它成立的速度场,不必先把路径解释成某个前向扩散 SDE。
所以更准确的说法是:Flow Matching 提供了一个更一般、直接的动态运输视角;扩散路径可以被包含在其中,直线 OT 路径则提供了扩散之外的选择。
十四、当前值得继续研究的问题
1. 好的 coupling 到底应在哪个表示空间定义
像素 L2、VAE latent L2、自监督特征距离和文本语义距离会给出不同配对。耦合越“语义正确”,是否一定越利于低 NFE,目前并没有跨数据集的简单答案。
2. 怎样联合优化 path、time sampling 与 solver
训练时的 MSE 最优不等于离散 solver 下的最终质量最优。更理想的设计可能直接考虑部署 NFE、局部截断误差与 CFG 后的场,而不是先训练连续模型、最后才挑 sampler。
3. DiT 的二次注意力如何跨分辨率扩展
降低 patch size 会迅速增加 token。稀疏 / 局部注意力、多尺度或 hourglass 结构、token merging、线性注意力和更好的 latent 表示,都在尝试把计算用在真正需要的空间区域。
4. Autoencoder 会不会成为下一堵墙
原始 latent diffusion 依赖重建型 VAE。后续 Representation Autoencoder 等路线尝试让潜变量同时拥有更强语义与更好重建能力,但高维 latent 又会增加 DiT 的 token / channel 成本。表示质量与生成计算之间仍有明显张力。
5. 连续 Flow 能否自然推广到离散数据
文本、图、分子类别等对象不在普通欧氏空间中。离散 Flow Matching、Riemannian Flow Matching 和一般状态空间上的 transport,正在把“速度场”从向量位移推广为概率质量的跳转率或流量。
十五、最后用一句话记住两者
如果把生成模型想成一条从高斯噪声流向真实数据的河:
- Flow Matching 决定河道在每个时间切片上的流速,并给出怎样从局部样本学习这张流速图;
- DiT 把带噪潜变量切成 token,用大规模 Transformer 根据时间与条件估计那支速度向量;
- ODE solver 决定我们用多少次、以什么精度查询这张流速图;
- VAE 决定这条河究竟流在怎样的表示空间里。
最值得带走的不是某个固定公式,而是一种拆问题的方法:
先区分概率路径、条件桥、边缘速度场与数值轨迹;再区分训练目标、网络骨干、条件机制与采样器。只有这些变量被分开,Flow Matching + DiT 的实验结论才真正可解释。
参考论文与官方资料
- Yaron Lipman et al. Flow Matching for Generative Modeling, ICLR 2023.
- Yaron Lipman et al. Flow Matching Guide and Code, 2024;官方 PyTorch 实现.
- Xingchao Liu, Chengyue Gong, Qiang Liu. Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow, ICLR 2023.
- Michael S. Albergo, Nicholas M. Boffi, Eric Vanden-Eijnden. Stochastic Interpolants: A Unifying Framework for Flows and Diffusions, JMLR 2025.
- William Peebles, Saining Xie. Scalable Diffusion Models with Transformers, ICCV 2023;官方项目页;官方代码.
- Nanye Ma et al. SiT: Exploring Flow and Diffusion-based Generative Models with Scalable Interpolant Transformers, ECCV 2024;项目页.
- Patrick Esser et al. Scaling Rectified Flow Transformers for High-Resolution Image Synthesis, ICML 2024;Stability AI 官方研究页.
- Black Forest Labs. FLUX.1 官方实现与模型卡.
评论