MiniMax H3 是怎样做出来的:从多模态素材到 2K 音视频的完整流程
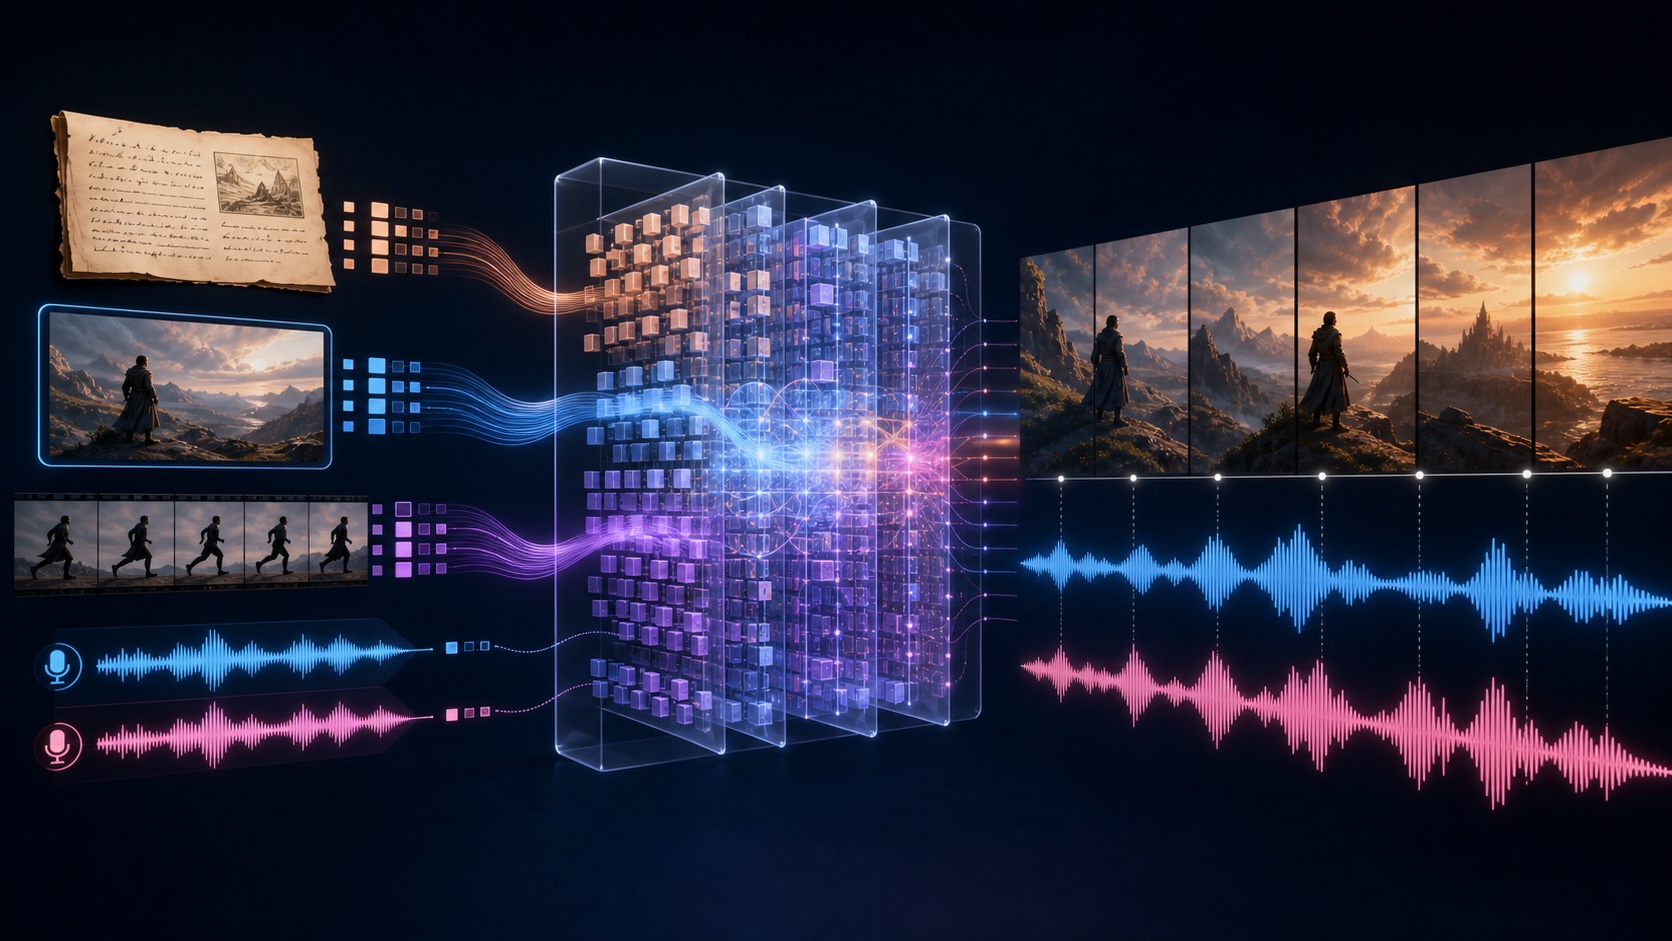
如果只用一句话概括 MiniMax H3:
它是一套以语言为任务接口、以 VAE latent 为视频和声音载体、以 33B 单流 Transformer 为联合生成核心、以 Rectified Flow 从噪声还原内容,再用上下文内再生成完成 2K 输出的全模态视频系统。
这句话听起来很密。先换成电影制作的比喻:
- H3-Context-IR 像导演和制片。它先读懂剧本、人物照片、动作参考、配音和镜头样片,明确每份素材究竟负责什么。
- H3-Base 像摄影、表演、录音同时工作的片场。它不是先拍默片再配音,而是在同一个生成循环里同时决定画面和声音。
- H3-Regenerate-2K 像带着原剧本和粗剪重新拍精细版本。它不只是把 768p 像素放大,而是重新读取人物、文字、镜头和声音上下文,生成 2K 细节。
这也是本文最重要的阅读框架。
先看结论:
- H3 于 2026 年 7 月 31 日发布,8 月初开放 H3-Base 权重;输出规格为 4–15 秒、24 FPS、32 kHz 双声道,官方完整系统最高输出 2K。
- 完整系统有
H3-Context-IR → H3-Base → H3-Regenerate-2K三段,当前真正公开权重的核心是 768p 的 H3-Base。 - H3-Base 使用完整的 Qwen3-VL-32B 作为条件编码器,并把其第 50 层隐藏状态交给生成模型。
- 视频由空间压缩 16 倍、时间压缩 4 倍的 24 通道 VisualVAE 表示;声音由 40 Hz、32 通道的 AudioVAE latent 表示。
- 生成主干是 33B dense single-stream Transformer。画面、声音与条件行被打包进一条序列,Attention 和 FFN 没有模态专属结构。
- 视频和音频在同一次 Transformer 前向中共同预测,但分别使用
shift=12和shift=3的 Rectified Flow 日程。 - 公开 checkpoint 已做 CFG distillation,因此推理时没有 negative prompt,也不需要传统 CFG 的两次前向。
- 官方没有公开训练数据量、训练算力、完整损失配比、Context-IR 内部模型与 2K 再生成权重。本文会明确区分“已证实”与“合理还原”。
一、先统一证据标准:哪些是事实,哪些只能推断
分析新模型最危险的做法,是把宣传文案、开源代码和行业常识搅在一起,最后写成一段听起来很完整、其实无法验证的故事。
本文采用三档证据:
| 标记 | 含义 | 例子 |
|---|---|---|
| 官方披露 | MiniMax 发布页、模型卡或许可证明确写出 | 33B Transformer、VAE 压缩率、24 FPS、训练任务范围 |
| 代码确认 | 权重配置、调度器或 Diffusers 实现可以直接验证 | 50 层、56 个注意力头、Flow 的符号、视频/音频 shift |
| 分析还原 | 由公开推理轨迹和生成模型原理推导,但完整训练细节未披露 | Flow Matching 的训练插值公式、可能的阶段衔接 |
MiniMax 没有发布一篇包含数据规模、训练 FLOPs、消融实验和完整损失函数的 H3 技术论文。因此,所谓“完整分析”不应意味着假装知道所有内幕,而应意味着:把公开系统完整接起来,并准确画出未知区域的边界。
二、H3 到底能做什么
根据 MiniMax 官方发布页 与 H3 开源模型卡,H3 接受文本、图片、视频和音频构成的上下文,输出同步视频与原生双声道。
| 项目 | 官方规格 |
|---|---|
| 输出时长 | 4–15 秒,整数秒 |
| 帧率 | 24 FPS |
| 音频 | 32 kHz、双声道 |
| 分辨率 | H3-Base 默认短边 768;完整系统可经 Regenerate-2K 输出 2K |
| 画幅 | 包括 21:9、16:9、4:3、1:1、3:4、9:16 |
| 稳定对白语言 | 阿拉伯语、中文、英语、法语、德语、意大利语、日语、韩语、葡萄牙语、俄语、西班牙语 |
开放权重分成两个任务 checkpoint:
| 公开模型 | 输入 | 主要用途 |
|---|---|---|
H3-Base-FL2VA | 文本 + 0/1/2 张图片 | 文生音视频、首帧、尾帧、首尾帧控制 |
H3-Base-Ref2VA | 文本 + 图片/视频/音频参考 | 主体、动作、镜头、风格、音色、节奏、编辑与续写 |
Ref2VA 最多接受 9 张图片、3 段视频、3 段音频,混合文件总数不超过 12;视频和音频参考总时长分别不超过 15 秒。官方开放说明还指出,音频参考需要和图片或视频一起使用,不能作为唯一输入。
这里已有一个值得注意的细节:“任务统一”是模型的训练理念和表示方式,不等于发布包中只有一个 Transformer 文件。两个公开 checkpoint 共享编码器、VAE 与调度器,但 FL2VA 和 Ref2VA 各有一份专门的 Transformer 权重。
三、完整产品流程:H3 其实是三个系统
1. H3-Context-IR:先把“我要什么”编译成模型能执行的上下文
用户可能说:
参考视频 1 的希区柯克变焦,让图片 2 中的人物唱歌,声音参考音频 3,最后镜头停在产品 Logo 上。
这不是普通提示词,而是一份包含引用关系、时间关系、保留关系和编辑关系的任务书。H3-Context-IR 需要完成:
- 解析用户指令;
- 判断每个参考文件的角色;
- 建立人物、动作、镜头、声音与目标视频之间的对应;
- 理解视频内部的时间结构;
- 补足不违背原意的必要细节;
- 序列化成 H3-Base 接受的 Context Intermediate Representation。
官方明确说明,Context-IR 依赖多个托管模型和服务,是多阶段工作流,没有包含在开源发布中。API 生成效果比“把原始短提示词直接喂给本地 Base”更稳定,原因不一定是 Base 权重不同,也可能是前面的任务编译质量不同。
2. H3-Base:在 latent 空间联合生成 768p 画面和声音
H3-Base 接收 Context-IR,把文本、参考视觉、参考声音和待生成噪声编码并打包,再用 H3-Omni-Transformer 反复预测视频与音频的去噪方向。结束后:
- H3-VisualVAE 把视频 latent 解码成 RGB 帧;
- H3-AudioVAE 把左右声道 latent 解码成波形;
- 调用方把帧与声音封装进视频文件。
“联合生成”发生在 latent 的去噪循环里,而不是最后封装 MP4 时。
3. H3-Regenerate-2K:不是传统超分,而是带上下文重做
传统超分辨率模型通常只看到低清图像:它知道哪里模糊,却不知道海报上本来应该写什么、人物胸前的徽章属于哪个品牌。
H3 的 2K 路径把两类信息一起送回生成系统:
\[\text{768p 初稿}+\text{原始多模态上下文}\longrightarrow\text{2K 再生成结果}.\]因此它可以依据原提示、参考图片和目标关系重新生成小字、纹理、人物特征与品牌细节,而不是只对像素做局部锐化。官方称之为 In-Context Regeneration。
更严谨的表述是:H3 的产品系统支持 2K 音视频输出;公开 Base 原生生成短边 768 的结果,再由未开放的上下文再生成模块完成 2K。把这整条路径简称为“原生 2K”容易掩盖内部的两阶段结构。
四、模型真正的第一步不是训练 Transformer,而是训练“描述能力”
1. 普通 caption 为什么不够
早期文生视频数据可能只有一句:
一个女人在雨中跑步。
但全模态生成需要知道更多:
- 女人是否来自参考图片;
- 跑步动作是否来自参考视频;
- 镜头是跟拍、摇摄还是变焦;
- 雨声、脚步和对白在什么时候发生;
- 音频中的声音属于画内人物还是画外配乐;
- 多镜头之间谁保持身份一致;
- 目标是生成、编辑、续写,还是只迁移动作。
H3 把这类描述称为 Contextual Omni Representation。语言在这里不只是场景说明,而是连接模态和定义任务的通用协议。
2. 官方披露的数据理解管线
MiniMax 表示,为了生产这种表示,团队定制了全模态理解模型和处理管线;大部分素材的理解过程会消耗约 100K token 推理,最终得到平均约 4K token 的描述。
可以把它理解为数据工厂中的一个“慢编译器”:
原始图片 / 视频 / 音频 / 多镜头素材
        ↓
主体识别、镜头切分、动作理解、转写、声音事件、跨模态对应
        ↓
长链路全模态推理(多数素材约 100K token 计算)
        ↓
平均约 4K token 的上下文表示
        ↓
成为 H3 预训练的条件与监督
这一步为什么重要?因为模型能不能执行“保留 A 的人物、迁移 B 的动作、使用 C 的音色”,首先取决于训练数据有没有用稳定语言表达过这种关系。
3. 已公开与未公开的边界
官方公开了原则:广义参考与编辑数据由真实自然数据构成,关系用自然语言表达;不同数据和任务尽可能早地混合,配比很关键。
但下列信息没有公开:
- 训练视频、图片与音频的总量;
- 数据来源、授权结构与去重比例;
- 质量评分、审美过滤和安全过滤的具体模型;
- 各任务、分辨率、语言和时长的采样比例;
- 合成数据占比;
- 数据清洗与人类标注成本。
因此不能负责任地写出“H3 用了多少亿条视频”之类的数字。
五、训练任务为什么要尽早混在一起
Hailuo 01 的目标是从零建立视频生成系统;Hailuo 02 主要提升架构效率、数据质量和规模。到 H3,设计中心从“把某个视频任务做强”转向“让任务本身可由语言自由定义”。
官方列出的预训练范围包括:
- 文生图;
- 文生视频;
- 画面与原生双声道联合生成;
- 原生多镜头建模;
- 文生音频;
- 不区分人声、音效、音乐的联合声音建模;
- 图片到图片的参考和编辑;
- 图片到视频的参考和编辑;
- 音频到音频的参考和编辑;
- 音视频到音视频的参考和编辑。
传统做法往往是一个基础模型外接许多 ControlNet、身份适配器、动作模块、口型模块和音频模型。H3 的目标则是把它们改写成同一形式:
\[\text{多模态上下文}+\text{自然语言描述的关系}\longrightarrow\text{目标音视频}.\]“尽早混合”有两个含义:
- 模型在预训练期就看到不同任务,不等基础模型完成后再逐个外挂能力;
- 同一种参数必须在生成、参考、编辑、音频与视频之间复用,从而逼迫模型学习可迁移表示。
代价也很明显:样本长度差异更大,理解部分和生成部分的计算负载不同。MiniMax 称多模态上下文让序列长度方差增加约 3 倍,因此采用理解与生成异构的训练架构,结合样本内异构计算和样本间负载均衡,使端到端训练吞吐提升接近 30%。这里说的是训练系统优化,不是模型质量直接提升 30%。
六、H3-VAE:先把视频和声音压到可学习的 latent 空间
像素不是合适的视频语言。十秒 2K 视频含有数十亿像素通道值,如果每个像素都成为 Transformer token,自注意力的成本会失控。
H3 使用两个独立的连续 VAE latent:一个表示视频,一个表示声音。
1. H3-VisualVAE
公开配置把它记为 f16t4d24:
- 空间高、宽各压缩 16 倍;
- 时间压缩 4 倍;
- latent 有 24 个通道;
- 时间上是 causal video autoencoder;
- 进入 Transformer 前再按
(时间, 高, 宽)=(1,2,2)切 patch。
所以 Transformer 看到的有效空间降采样是 32 倍,时间仍是 4 倍。
这里的 token 不是像 LLM 词表那样的整数编号。每个视频 token 来自 2×2×24=96 个连续 latent 值,再线性投影到 Transformer 隐藏维度。
VAE 的训练目标也不只是“重建图像好看”。如果 latent 分布扭曲、局部不连续,后面的生成模型即使参数再大,也很难从高斯噪声沿一条平滑路径走到真实视频。因此官方强调同时优化:
- reconstruction quality:解码后还原细节;
- latent learnability:让生成模型容易学习 latent 分布。
VisualVAE 编码器训练后,MiniMax 还训练了一个 ViT-based decoder,以降低解码成本并进一步改善重建。官方称新 tokenizer 相比前代带来约 4 倍序列长度收益,这是训练、推理和 2K 成本结构的关键。
2. H3-AudioVAE
音频侧将每个声道的 32 kHz 波形压缩为 40 Hz、32 通道的 latent 序列。换句话说,一秒 32,000 个采样点变成约 40 个连续时间步。
左右声道:
- 使用同一套 AudioVAE encoder/decoder 权重;
- 分别编码和解码;
- 最后重新组合成立体声。
共享权重保证左右耳使用相同的声学表示规则;独立 latent 则保留空间差异。它不是把单声道复制两份。
七、H3-Encoder:同一张参考图为什么要编码两次
H3 使用完整预训练权重的 Qwen3-VL-32B 作为 H3-Encoder,并读取其第 50 层隐藏状态,而不是最终语言模型输出。
不同输入的路径是:
| 输入 | 编码路径 | 作用 |
|---|---|---|
| 文本 | H3-Encoder | 提供任务、关系和语义条件 |
| 图片/视频参考 | H3-Encoder + H3-VisualVAE | 同时提供“它是什么”与“它具体长什么样” |
| 音频参考 | H3-AudioVAE | 提供连续声音 latent |
| 待生成视频/声音 | 从随机 latent 噪声开始 | 在 Flow 循环中逐步形成目标 |
视觉参考为什么走两路?
- Qwen3-VL 的隐藏状态更擅长表达主体、场景、文字、动作类别和引用关系;
- VisualVAE latent 更接近颜色、纹理、构图和逐帧局部细节。
只保留语义,人物可能“还是同一个类型”却不像参考对象;只保留低层 latent,模型又可能不知道用户要求迁移的是动作、风格还是镜头。两路表示互补。
八、H3-Omni-Transformer:把所有模态装进同一条序列
公开 transformer/config.json 给出的主干规格是:
| 参数 | 数值 |
|---|---|
| 总参数量 | 33B dense Transformer |
| Transformer blocks | 50 |
| token refiner blocks | 2 |
| hidden size | 5,376 |
| attention heads | 56 |
| head dimension | 128 |
| FFN dimension | 14,336 |
| 视频输入通道 | 24,patch 后每 token 96 值 |
| 音频输入通道 | 32 |
| 文本条件维度 | 5,120 |
1. 单流的意思:没有另外一套跨注意力
公开 Transformer 实现明确写明:H3 没有 cross-attention。输入投影后,文本、视频和音频占据 packed sequence 中不同的行,随后做全 self-attention。
可以把序列想成:
[文本条件行]
[参考图的视觉语义行]
[参考视频 latent 行]
[待生成视频噪声行]
[参考音频 latent 行]
[待生成音频噪声行]
每一行还带三类元数据:
token_tags:0 表示视频、1 表示文本、2 表示音频;position_ids=(t,h,w):表示时间与两个空间坐标;timestep_indices:说明该行当前处于哪一个噪声时刻。
三维 Multimodal RoPE 把 (t,h,w) 写入注意力的 Query 和 Key,使模型区分“同一帧不同位置”“同一位置不同时间”以及音频时间线。
2. 模态专属参数放在哪里
H3 的 Attention 和 FFN 没有视频专用或音频专用专家。模态差异主要存在于:
- 输入投影;
- 输出投影;
- modality-specific AdaLN 分支。
AdaLN 根据噪声时间和模态,为每一层产生缩放、偏移和门控。这样同一套 Attention/FFN 可以复用,但“视频处于第几步”和“音频处于第几步”仍能得到不同调制。
33B 参数中约 13B 位于 AdaLN 相关分支。官方说明这些调制输出可预计算并缓存,因此纯推理部署可以不加载相应参数;完整权重仍被发布,便于微调。
3. 为什么需要稀疏注意力
前面的 5.2 秒例子仅目标视频就有 37,296 个 token,再加入几千个文本/视觉语义 token、参考视频和音频,序列会很长。全注意力成本近似:
\[O(N^2).\]H3 在训练后期引入原生 sparse attention,并原生支持稀疏注意力训练与推理。不过截至本文日期,首批开放代码只提供 full attention,官方计划以后发布稀疏实现。
九、Rectified Flow:H3 怎样把随机噪声变成音视频
1. 先用直觉理解
想象空间中有一团随机噪声,也有真实视频 latent。训练时,从两者之间的连线上随机选一点,问模型:
从这里往哪个方向走,能更接近真实数据?
模型学会一个速度场。推理时从纯噪声出发,反复询问速度,再用数值积分向干净数据移动。
这就是 Rectified Flow 的基本图景。它与扩散模型都从噪声开始,但训练和采样常被描述为学习较直的概率流路径。H3 的公开调度器使用 Euler 更新,且 eta=0,中途不重新注入随机噪声。
2. 从公开 sampler 可以确认的符号
令干净 latent 为 $x_0$,高斯噪声为 $\epsilon$,噪声强度为 $\sigma$。与公开调度器一致的一条线性路径是:
\[x_\sigma=(1-\sigma)x_0+\sigma\epsilon.\]H3 预测的是朝数据方向的速度:
\[v=x_0-\epsilon.\]所以可以由当前状态估计干净样本:
\[\hat x_0=x_\sigma+\sigma v_\theta(x_\sigma,\sigma,c).\]其中 $c$ 是文本和多模态上下文。训练通常让 $v_\theta$ 接近真实方向 $x_0-\epsilon$。需要强调:公开代码确认了 Rectified Flow 采样轨迹、速度方向与 Euler 更新,但官方没有发布训练损失权重、噪声采样分布和各模态损失比例。
3. 一次前向,两套噪声日程
公开配置使用:
\[\operatorname{shift}(\sigma;s)=\frac{s\sigma}{1+(s-1)\sigma}.\]- 视频 scheduler:$s=12$;
- 音频 scheduler:$s=3$。
两种 latent 的统计结构不同:视频 token 数量大、空间结构强;音频时间分辨率和信号分布不同。让两者共用完全相同的步长不一定合适。H3 的做法是:同一次 Transformer 调用同时输出两种速度,然后各自用对应 scheduler 更新。
因此“联合”不等于所有数值处理都相同,而是它们在每一步都能通过 self-attention 交换信息。
4. CFG distillation 为什么能省一次计算
普通 classifier-free guidance 每一步需要:
- 有条件前向;
- 无条件前向;
- 按 guidance scale 合成两种预测。
H3 发布的是 CFG-distilled 权重,引导效果已经蒸馏进模型。公开推理每一步只需一次前向,没有 negative_prompt 和 guidance_scale。对一个 33B、数万 token 的视频模型而言,省掉第二次前向非常关键。
十、把“模型怎样做出来”还原成一条训练工程路线
根据官方披露和开源结构,可以把 H3 的研发过程还原成下面七个工作包。它不是官方给出的逐日训练日志,而是目前证据能支持的最完整工程图。
工作包 A:建立全模态数据理解与 caption 工厂
- 收集并清洗图片、视频、音频、多镜头和参考/编辑关系数据;
- 训练或组合素材理解、转写、镜头解析、声音事件与跨模态关联模型;
- 把素材编译成平均约 4K token 的 Contextual Omni Representation;
- 对质量、版权、安全和任务关系做筛选。
只有“约 100K token 推理得到平均约 4K token 表示”和任务设计被披露;规模、来源、清洗阈值未知。
工作包 B:分别训练视觉与音频 VAE
- VisualVAE 学习视频到连续 latent 的压缩和重建;
- 同时优化 latent 的可生成性,避免只追求像素重建;
- 在编码器之后训练 ViT decoder;
- AudioVAE 学习 32 kHz 波形与 40 Hz latent 之间的转换,并处理双声道。
如果 VAE 重建不好,Transformer 不可能恢复其已经丢掉的细节;如果 VAE latent 难学,生成主干会付出更大模型和更多采样步。
工作包 C:建立条件理解入口
- 载入完整 Qwen3-VL-32B 预训练权重;
- 扩展 tokenizer 特殊 token,例如对白标记
<d>; - 选取第 50 层隐藏状态作为 5,120 维条件;
- 让视觉参考同时进入语义编码和 VAE 编码。
官方没有说明 H3 训练时 Qwen 权重是全量更新、部分更新还是阶段性冻结;“使用完整预训练权重”不等于“整个训练过程始终冻结”。
工作包 D:预训练单流 Omni Transformer
- 把文本、视觉、音频与目标噪声打包为统一序列;
- 用任务标签、三维位置和噪声时间区分不同 token;
- 在文生图、文生视频、音频生成、多镜头、参考和编辑等数据上尽早混合训练;
- 让同一主干学习视频与音频速度场。
公开信息没有给出 batch size、optimizer、学习率、训练 token 总数、分辨率 curriculum 或训练时长。
工作包 E:扩展长序列与提高训练吞吐
- 按理解和生成的异构 workload 安排硬件;
- 处理样本内计算差异和样本间负载均衡;
- 在训练后期引入原生 sparse attention;
- 让不同长度、画幅、时长与参考数量可以混合。
工作包 F:对推理进行蒸馏和任务发布适配
- 把 CFG 行为蒸馏进 checkpoint,减少每步前向次数;
- 发布 FL2VA 与 Ref2VA 两份 Transformer 权重;
- 适配 SGLang、vLLM、Diffusers 和 ComfyUI。
官方没有说明两份 checkpoint 从统一预训练模型分化的具体阶段和额外数据。
工作包 G:搭建产品系统
- 用托管 H3-Context-IR 把用户输入编译成稳定条件;
- H3-Base 本地或云端生成 768p 音视频;
- 把 768p 结果和原始上下文送给 Regenerate-2K;
- 添加审核、任务调度、存储、封装与 API。
所以,“做一个 H3 级视频模型”远不只是训练一个 DiT checkpoint。真正的工程包括数据解释系统、两个 tokenizer/VAE、条件编码器、联合生成主干、分布式长序列训练、蒸馏、2K 再生成与产品编排。
十一、一次真实推理请求内部发生了什么
假设输入是:
使用图片 1 的人物,模仿视频 1 的推进变焦动作,让她用音频 1 的音色说“我们到了”,保留雨声,生成 8 秒 16:9 视频。
完整云端路径大致如下:
第 1 步:安全与格式检查
检查文本和媒体,读取分辨率、帧率、采样率与时长,拒绝不合规或超限输入。
第 2 步:Context-IR 编译任务
把关系写清楚:
<Subject 1>的外观来自图片 1;- 镜头运动参考
<Video 1>; - 说话人音色参考
<Audio 1>; - 对白发生在哪个时间段;
- 雨声属于画内环境音;
- 目标时长、画幅和镜头结构。
第 3 步:编码条件
- Qwen3-VL 编码文本、图片与视频语义;
- VisualVAE 编码参考图片/视频的连续视觉 latent;
- AudioVAE 编码参考音频;
- 新建目标视频噪声和双声道音频噪声。
第 4 步:打包序列并设置位置
为每行分配模态 tag、(t,h,w) 位置和 timestep。参考行保持为条件,目标行参与更新。
第 5 步:联合 Flow 采样
每个采样步:
Packed Sequence
    ↓
H3-Omni-Transformer 一次前向
    ├── 视频速度预测 → 视频 scheduler 更新
    └── 音频速度预测 → 音频 scheduler 更新
    ↓
更新后的两种 latent 再次共同进入下一步
口型与声音能对齐,不是因为最后有一个独立 lip-sync 修补器,而是因为视频与声音 token 在生成过程中反复互相注意。当然,产品链路是否还包含未公开的后处理,官方没有完整披露,不能断言绝无额外修正。
第 6 步:分别解码并封装
VisualVAE 输出 RGB 帧,AudioVAE 输出左右声道波形。开源 Diffusers 调用会分别返回 videos、audio 和 sampling_rate,再由调用方封装成带声音的视频文件。
第 7 步:2K 再生成
如果请求 2K,系统把初稿与原始 Context-IR 送入 Regenerate-2K,恢复细文字、纹理和身份细节。
十二、怎样写 H3 真正容易执行的提示词
H3 能理解自然语言,不等于提示词越随意越好。复杂视频需求最好写成一份短小、时间可执行的拍摄计划。
官方 H3 prompt writing skill 对基础模式推荐三个字段:
integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...
分别表示:
- 逐镜头画面、动作、摄影机、对白和同步声音;
- 整体环境声与物理声音;
- 只有观众能听见的画外配乐。
例如一个 8 秒文生音视频提示:
integrated_multimodal_description: [Shot 1] Live-action, cinematic, a medium-wide shot frames a woman standing under a transparent umbrella at a rain-soaked railway platform. The camera pushes in slowly as an arriving train appears behind her. The woman with a calm low voice (S1) looks toward the camera and says: <d>[Chinese] 我们到了。</d> [Shot 2] At 00:05.000, the camera cuts to a close-up of rain sliding across the umbrella while the train stops in the background.

overall_soundscape: Steady rain strikes the umbrella and platform. The train wheels produce a rising metallic rumble, followed by the soft hiss of brakes.

non_diegetic_music: Sparse piano notes at a slow tempo, joined by a sustained low cello tone that fades at the end.
几个实用原则:
- 总时间要能容纳动作和对白,不要在 5 秒里塞五次转场;
- 镜头运动写清类型、幅度和速度;
- 对白保留原语言并放进
<d>[语言] ...</d>; - 区分画内声音和画外配乐;
- 多参考输入使用稳定标签,不要让同一张图一会儿叫人物图、一会儿叫图 3;
- 首尾帧任务重点描述中间怎样变化,不要只重复两张静态图。
十三、本地部署需要多大机器
开放权重不等于普通显卡可以轻松运行。
Diffusers 的 H3 文档给出大致体量:
- 单份 H3 Transformer 约 61.7 GB BF16;
- Qwen3-VL 条件编码器约 62.1 GB;
- 另有 VisualVAE、AudioVAE 与运行时激活;
- 不指定工作流而同时加载 FL2VA 和 Ref2VA,会再加载第二份 Transformer。
官方 SGLang 示例使用 4 张 GPU 做序列并行。Diffusers 给出的单卡方案包括:
- 一张 80 GB GPU 配合 CPU offload;
- 24–32 GB GPU 使用 INT8 权重量化和 block streaming;
- 12–16 GB GPU 进一步 offload VAE,并降低画布到 960×544 一类尺寸。
低显存方案不代表体验相同:它通常需要约 75 GB 系统内存保存 INT8 大权重,并频繁在 CPU 与 GPU 间搬运,速度会显著下降。公开本地路径主要验证 768p;官方 2K 还需要 Regenerate-2K API。
十四、H3 的优势来自哪里
1. 语言不只是提示词,而是任务协议
Contextual Omni Representation 把“生成/编辑/参考/迁移”改写成上下文关系,减少为每个新任务设计独立模型接口的需求。
2. 高压缩 VAE 直接决定序列成本
视频模型最贵的不只是参数,而是 token 数。空间有效 32 倍、时间 4 倍的压缩,让较高分辨率和多参考序列进入可计算范围。
3. 单流让音画在生成中交换信息
声音不是最后附加。对白、动作、环境和节奏可以在每一次 self-attention 中互相条件化。
4. 模态专属 AdaLN 在共享与差异之间折中
主干 Attention/FFN 共享,提高跨任务复用;AdaLN、输入输出头保留视频和音频的统计差异。
5. CFG 蒸馏和 2K 再生成优化了产品成本
CFG 蒸馏减少每步前向;2K 不要求 Base 从第一步就在最高分辨率的巨大序列上完成所有规划。
十五、不能忽略的局限与开放边界
1. 15 秒仍然是短片模型
H3 可以原生多镜头,但 4–15 秒不等于能一次生成剧情完整、身份长期稳定的分钟级影片。长片仍需要分镜、续写、一致性管理和剪辑工作流。
2. “统一”不意味着永远正确理解冲突参考
多张人物图、动作视频、音色和镜头参考可能互相矛盾。Context-IR 能整理关系,却无法保证所有约束同时严格满足。
3. 物理、文字和复杂交互仍会累积误差
手部、遮挡、物体持握、反射、连续文字、小 Logo、多角色口型以及镜头切换后的身份稳定,仍是生成视频的高难区域。Regenerate-2K 能补细节,不能自动修复错误的事件逻辑。
4. 公开评估不够完整
当前发布没有提供足以独立复核的完整 benchmark 表、训练数据统计、消融实验和人评协议。官方样片说明能力上限,却不能代表任意提示词的平均成功率。
5. 它是开放权重,不是无条件的开源软件许可
MiniMax H3 Community License 有重要限制。截至 2026 年 8 月 25 日:
- 适用区域明确排除欧盟、英国、韩国和美国;这些区域需要另行联系授权;
- 年收入超过 2,000 万美元的商业产品/服务需要事先书面授权;
- 使用 H3 的商业产品界面必须显著显示“MiniMax H3”;
- 不得用 H3 或其输出改进 H3 衍生模型之外的其他 AI 模型;
- 托管服务需要实施内容安全措施。
因此更准确的术语是 open-weight / 开放权重模型,而不是“可以在任何地区、任何用途下自由使用的 OSI 开源模型”。这不是法律意见;部署前应阅读当时有效的完整许可证。
6. 完整系统尚未全部开放
截至本文日期,没有开放:
- H3-Context-IR 内部多阶段模型与服务;
- H3-Regenerate-2K 权重;
- 原生 sparse attention 实现。
只下载 H3-Base,不等于复现了官方云端 2K 产品的完整链路。
十六、几个最常见的问题
H3 是大语言模型吗?
不是。它使用 Qwen3-VL-32B 理解条件,但真正生成视频和声音的是 33B H3-Omni-Transformer。前者回答“输入在说什么”,后者学习“音视频 latent 应怎样从噪声形成”。
H3 的视频 token 是离散 token 吗?
不是公开架构中的主生成表示。H3-VisualVAE 输出连续 24 通道 latent,patchify 后成为连续 token embedding,再由 Rectified Flow 生成。
H3 是先生成视频再配音吗?
不是。视频和音频 latent 被装入同一 packed sequence,在每一步由同一 Transformer 共同预测;只是两者各有 scheduler 和输出头。
2K 是普通超分辨率吗?
不是传统只看低清结果的超分。H3-Regenerate-2K 同时读取 768p 初稿和原始多模态上下文,用生成模型重新生成高分辨率结果。
为什么本地短提示词可能不如官方产品?
官方产品前面有 H3-Context-IR,把自由输入改写成结构化多模态描述。本地只跑 Base 时,需要自己完成这层 prompt/context 编排。
为什么已经“任务统一”,还要两个 checkpoint?
统一表示和统一训练目标并不要求所有部署场景共用同一份最终权重。公开发布分别提供首尾帧家族和全参考家族,两者架构相同、共享其余组件,但 Transformer 权重独立。
十七、最后总结:H3 的创新不在单一模块,而在接口统一
单独看每个零件,H3 并非从零发明所有概念:VAE、视觉语言编码器、Transformer、RoPE、AdaLN、Flow Matching、蒸馏和稀疏注意力都有技术前史。
H3 更值得研究的是这些零件怎样围绕一个原则重新组合:
不要先规定用户在做文生视频、动作迁移、人物参考、视频编辑还是音色参考;先让语言描述上下文之间的关系,再让同一生成系统学习完成目标。
最终链路可以压缩成:
真实多模态数据
  → 长链路理解与 Contextual Omni Representation
  → VisualVAE / AudioVAE 连续 latent
  → Qwen3-VL 条件语义
  → Packed Multimodal Sequence
  → 33B Single-Stream Omni Transformer
  → 视频/音频双日程 Rectified Flow
  → 768p + 32 kHz 双声道
  → 原始上下文参与的 2K Regeneration
这就是目前公开证据能支持的 MiniMax H3 全流程:它既是视频模型,也是音频模型、上下文编译系统和高分辨率再生成工作流。理解它,不能只盯着 33B 参数;真正决定产品能力的,是数据怎样被描述、模态怎样共享序列、latent 怎样压缩,以及整条系统怎样把一次自由创作请求变成可执行的生成过程。
主要资料
- MiniMax,《MiniMax H3:打破任务和模态的边界》,2026-07-31。
- MiniMax,MiniMax H3 官方开源仓库与模型说明,访问于 2026-08-25。
- MiniMax,MiniMaxAI/MiniMax-H3 模型卡与权重配置,访问于 2026-08-25。
- Hugging Face Diffusers,MiniMax-H3 pipeline 文档,访问于 2026-08-25。
- Hugging Face Diffusers,MiniMax-H3 Transformer 实现,访问于 2026-08-25。
- Hugging Face Diffusers,MiniMax-H3 Rectified-Flow scheduler 实现,访问于 2026-08-25。
- Yaron Lipman et al., Flow Matching for Generative Modeling, 2022。
评论