大模型是怎样一步步“想”出答案的?
从一句提示词进入服务器,到屏幕上蹦出第一个字:一篇写给普通人的 Transformer 推理全流程
你在聊天框里输入:“小明有 3 个苹果,又买了 2 个,一共有几个?”几秒后,大模型回答:“5 个。”
这几秒里发生了什么?模型是不是先在脑海中理解题意,再从记忆里翻出加法规则,最后组织语言?
答案既像,又不像。
像,是因为模型内部确实会把词语放进上下文中比较,逐层提取关系,并可能生成若干中间步骤;不像,是因为它并没有一个藏在机房里的“小人”读题。归根结底,整个过程是大量矩阵乘法、归一化和概率选择。它每次最直接的任务只有一个:根据前面的内容,预测下一个 token。
这套看似朴素的机制,经过几十层甚至上百层 Transformer、海量参数和多轮训练后,便能表现出翻译、写作、编程和解题能力。
2017 年,Vaswani 等人在论文《Attention Is All You Need》中提出 Transformer。今天大多数文本大模型仍以它为基础,只是位置编码、归一化、前馈网络、注意力形式和部署方式已经有了许多改进。
一、先分清两个容易混淆的“推理”
中文里的“推理”常指两件不同的事:
- 模型推理(inference):训练完成后,把输入送进模型并生成输出。本文的大部分内容讲的是这个计算过程。
- 逻辑推理(reasoning):模型为数学题、代码或复杂决策寻找中间步骤、检查错误、修正路线。
二者的关系是:逻辑推理仍然由一次次模型推理完成。
所谓“思考 30 秒”,通常不是启动了另一颗神秘大脑,而是让同一个或相关的 Transformer 多生成一些中间 token,或者多做若干轮验证与选择。像 DeepSeek-R1 这类推理模型,会通过强化学习等训练方式,鼓励模型形成更长的解题、反思和自我修正轨迹;它的底层生成过程依然是自回归预测。DeepSeek-R1 论文展示了这种“用训练激励推理行为”的路线。
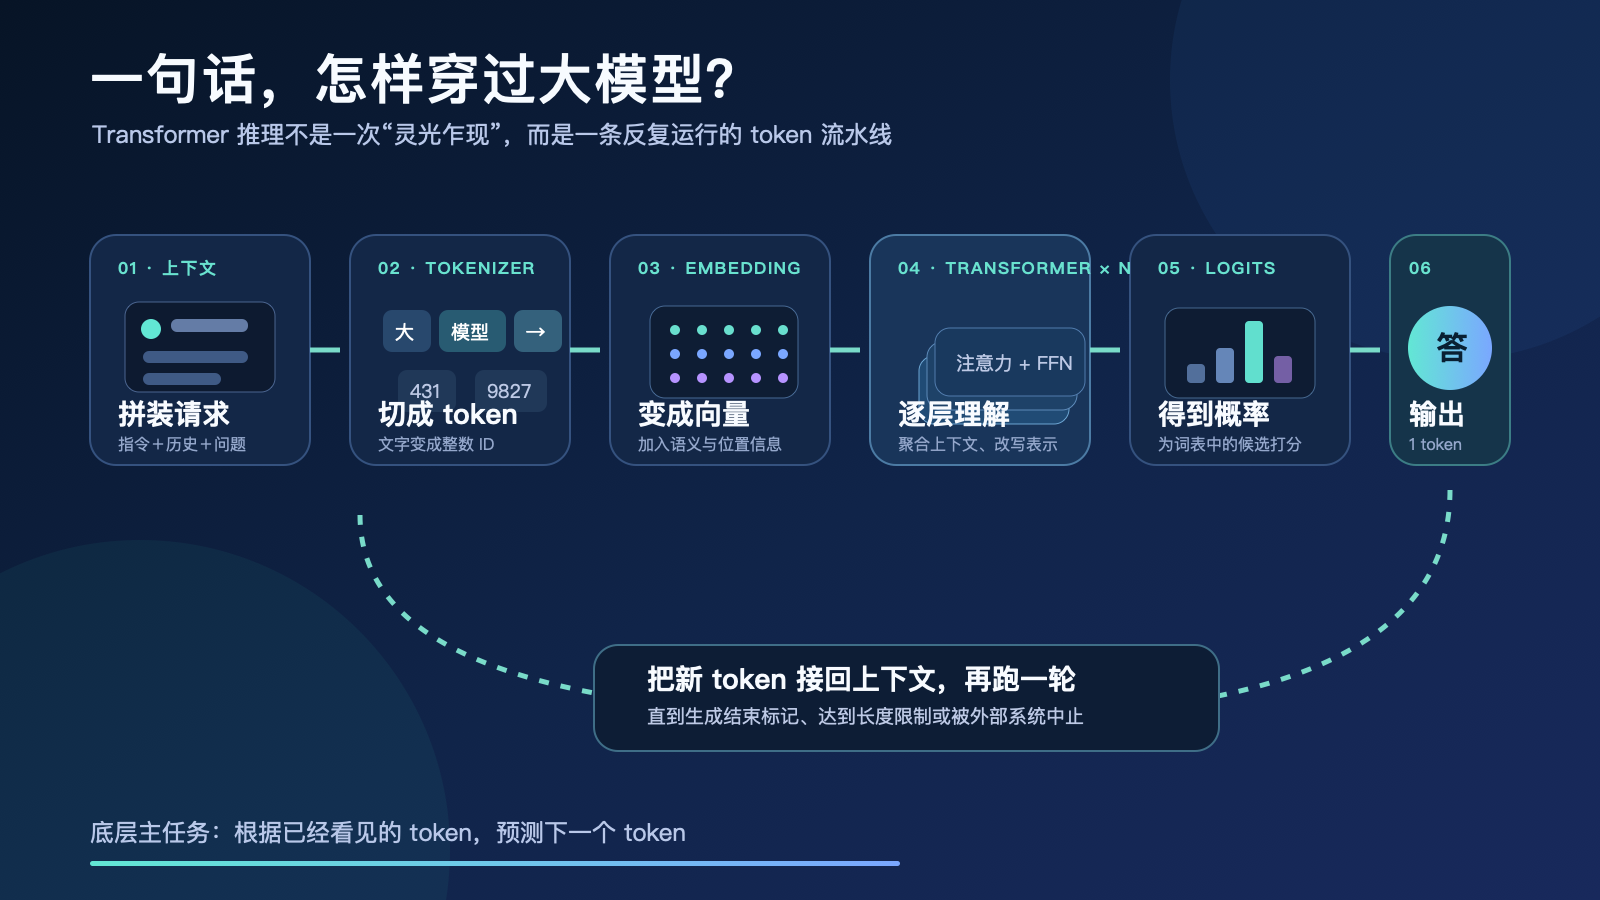
二、一张图看懂完整流水线
一条典型的文字生成请求,会依次经过:
拼装上下文 → 分词 → 向量化 → 多层 Transformer → 得到概率 → 选出一个 token → 把它接回上下文 → 再来一轮。
注意最后四步会不断循环,直到模型生成结束标记、达到长度限制,或者被系统中止。
举个极简例子。假设模型已经看见:
中国的首都是
它可能为下一个 token 算出一组概率:
| 候选 token | 概率(示意) |
|---|---|
| 北京 | 96.1% |
| 上海 | 1.2% |
| 中国 | 0.8% |
| 其他所有 token | 1.9% |
选中“北京”后,输入就变成“中国的首都是北京”,模型再预测句号或后续解释。真实模型的词表通常有数万到十多万个 token,概率也不会像示例这么整齐。
下面从入口开始,沿着一枚 token 的路线往里走。
三、第一站:系统先把“整场对话”拼起来
用户看到的输入也许只有一句话,但模型收到的往往是一整个上下文包,其中可能包括:
- 系统指令,例如“回答要安全、简洁”;
- 之前的多轮对话;
- 用户当前的问题;
- 工具说明和工具返回的数据;
- 用来标记角色、消息边界和结束位置的特殊 token。
这些内容会按一种称为 聊天模板(chat template) 的格式拼成序列。不同模型的模板不同,所以同一句话换一个模板,效果也可能变化。
这也解释了一个常见现象:对话越长,模型每次回答前需要读的内容通常越多。所谓“上下文窗口”,就是一次能纳入计算的 token 总量上限;它包含你的问题、历史消息、工具结果,以及模型将要生成的内容。
四、第二站:Tokenizer 把文字切成 token
大模型并不直接读取汉字或单词,而是先由 Tokenizer(分词器) 把文本切成 token,再把每个 token 映射成整数 ID。
例如,“大模型正在推理”可能被切成:
大模型|正在|推理
也可能被切得更碎。英文 unbelievable 也可能被拆成 un、believ、able。具体结果取决于模型自己的词表和分词算法。
需要特别记住三点:
- token 不等于字,也不等于词。 一个 token 可以是一个汉字、半个英文单词、一段标点,甚至一个空格组合。
- 模型看到的是 ID 序列,而不是屏幕上的字形。
- 计费、上下文长度和生成速度通常都按 token 计算。
如果把模型比作餐厅,Tokenizer 就像备菜员:先把整段文字切成厨房能处理的标准食材。
五、第三站:把 token ID 变成向量,并告诉模型位置
整数 ID 本身没有“意义”。于是模型会在一张巨大的 嵌入表(embedding table) 中查表,把每个 ID 换成一串浮点数,也就是向量。
可以把向量想象成 token 的“坐标卡”。它不是人工填写的词典解释,而是在训练中逐渐学出来的。语义、语法、风格等信息分散在很多维度及其组合中,很难把某一个维度单独翻译成人话。
但只有词向量还不够。下面两句话用词相同,意思却不同:
狗咬人。
人咬狗。
因此模型还要知道每个 token 的位置。原始 Transformer 使用正弦和余弦位置编码;许多现代大模型使用 RoPE(旋转位置编码) 或其变体,把相对位置信息融入 Query 和 Key。RoPE 的代表性论文是《RoFormer》。
经过这一步,模型手里有了两类线索:“这是什么”以及“它在哪里”。
六、核心车间:一层 Transformer 到底做什么?
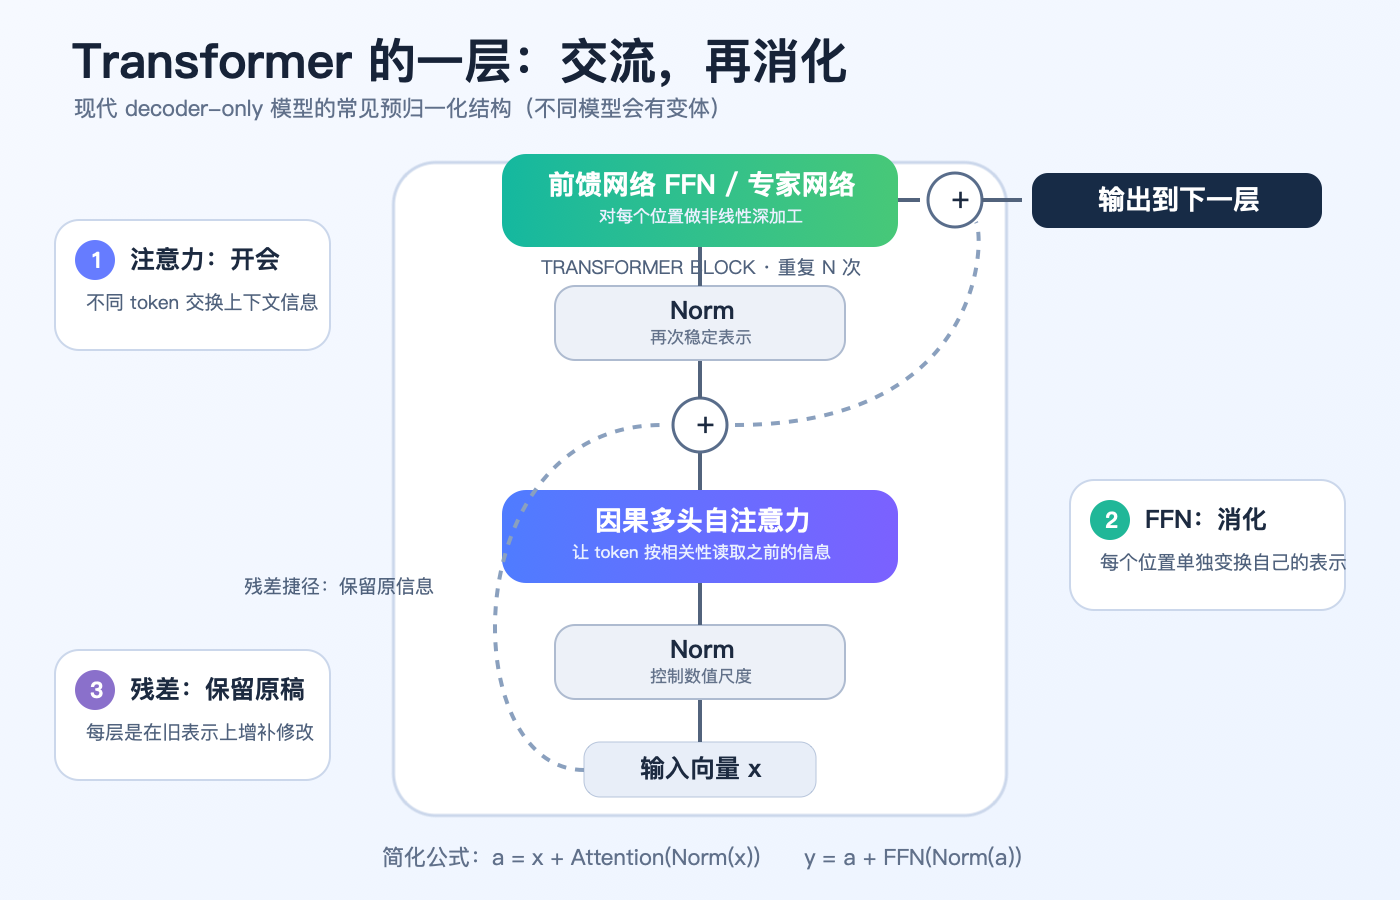
大模型会把输入向量依次送过很多个 Transformer 块。不同模型的细节不同,但一个现代 decoder-only 模型的典型块可以简化为:
- 归一化(Norm);
- 带因果遮罩的多头自注意力(Masked Multi-Head Self-Attention);
- 残差连接(Residual Connection);
- 再次归一化;
- 前馈网络(FFN/MLP,或 MoE 专家网络);
- 再次残差连接。
用简化公式表示:
a = x + Attention(Norm(x))
y = a + FFN(Norm(a))
其中 x 是这一层的输入,y 是输出。y 会继续送入下一层。这里采用的是常见的“预归一化”画法;具体模型也可能有不同次序和变体。
为什么要堆很多层?可以把它理解成多人接力读稿:浅层更容易处理局部搭配和表面模式,中间层逐渐组合句法与语义关系,深层把这些信息改造成适合当前预测任务的表示。这个说法只是帮助理解,真实模型并没有人工指定“第 8 层只管语法、第 20 层只管事实”。
1. 自注意力:决定“此刻应该重点看谁”
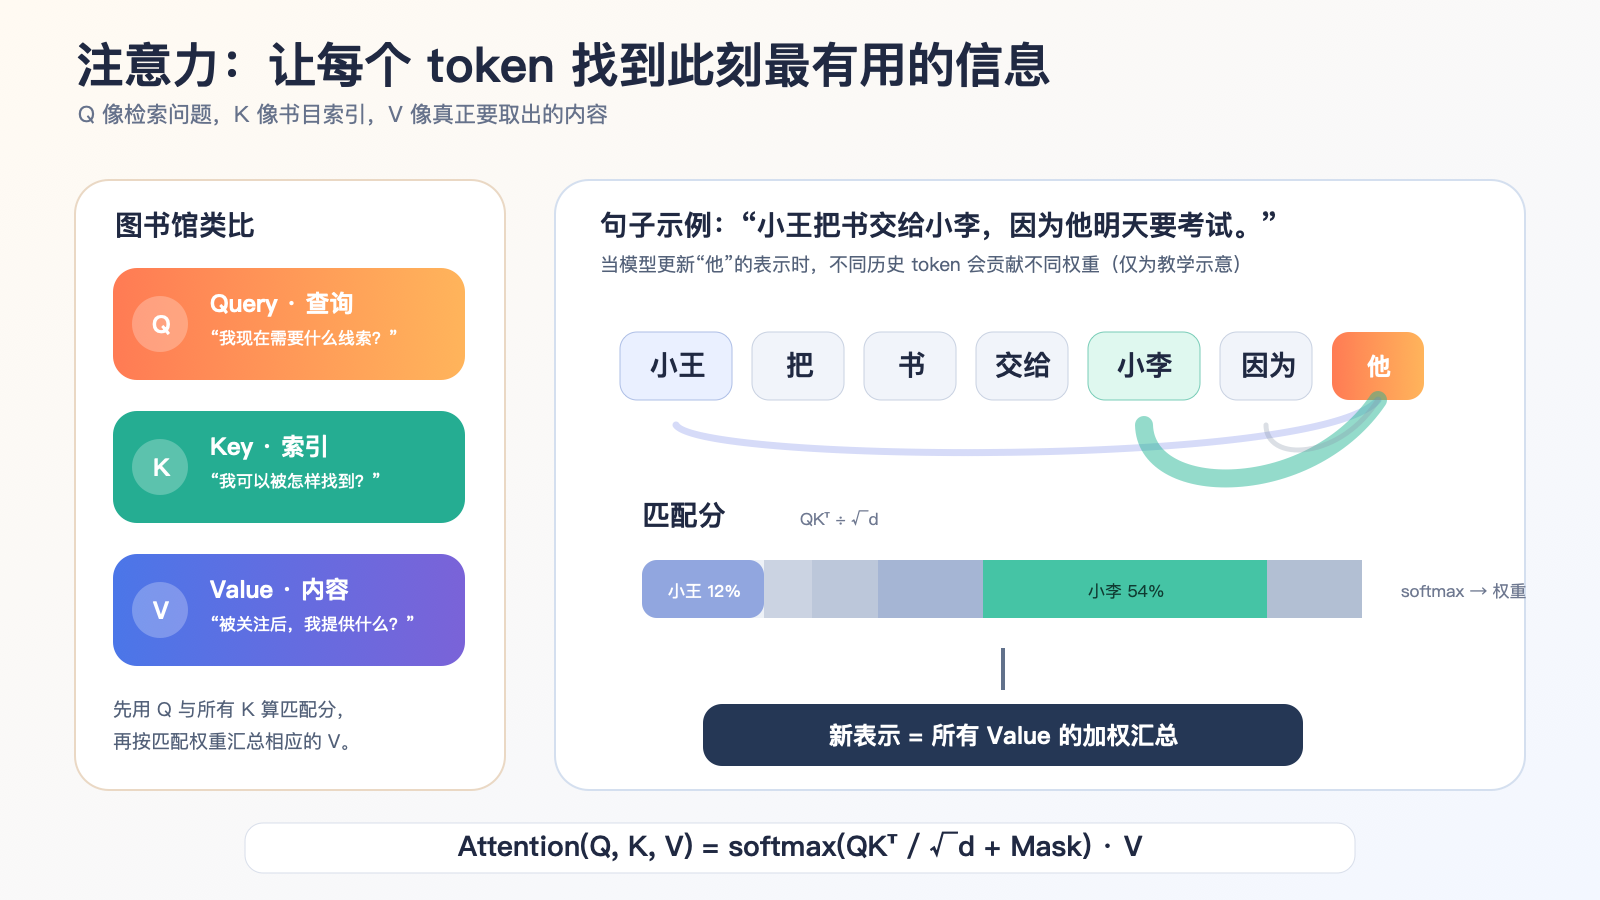
自注意力是 Transformer 最有代表性的部件。对每个位置的输入向量,模型通过三组学习到的矩阵,算出三个新向量:
- Query(Q,查询):我现在想找什么信息?
- Key(K,索引):我能用什么特征被别人找到?
- Value(V,内容):如果别人关注我,我实际提供什么信息?
它很像在图书馆检索:读者的问题是 Query,书背上的索引是 Key,书里的正文是 Value。
核心公式是:
Attention(Q, K, V) = softmax(QKᵀ / √d + Mask) · V
不必怕这串公式,它只做四件事:
- 用
QKᵀ比较当前 token 与其他 token 的匹配程度; - 除以
√d,避免数值随着向量维度增大而过分极端; - 用
softmax把分数变成总和为 1 的注意力权重; - 按这些权重对
V加权求和,把相关信息汇入当前 token。
假设模型处理:“小王把书交给小李,因为他明天要考试。”在理解“他”时,某些注意力头可能更关注“小李”,另一些头关注“考试”或动词关系。许多头并行工作,就是 多头注意力:大家从不同角度找线索,再把结果合并。
2. 因果遮罩:考试时不能偷看答案
生成式大模型通常使用 decoder-only Transformer。训练和生成时,第 i 个位置只能关注自己及之前的位置,不能偷看未来 token。这由因果遮罩(causal mask)实现。
如果序列是“今 / 天 / 天 / 气 / 好”,模型在处理第二个 token“天”时可以看“今”,却不能利用后面的“天气好”。这保证了模型学到真正的“根据过去预测未来”。
3. 前馈网络:对每个位置做一次深加工
注意力负责在 token 之间搬运和组合信息,前馈网络则对每个 token 的表示做非线性变换。可以粗略地把它理解为:注意力负责“开会交流”,前馈网络负责“各自回工位消化”。
现代模型常用带门控的 FFN,例如 SwiGLU。还有一些模型采用 MoE(Mixture of Experts,混合专家):每个 token 先经过路由器,再只激活少数几个专家网络。这样模型可以拥有很大的总参数量,却不必让每个 token 都经过全部参数。《Switch Transformers》是稀疏专家路线的代表工作之一。
4. 残差连接和归一化:让深层网络稳稳传话
残差连接把子模块的输出与原输入相加,相当于既保留旧信息,又写入新修改;归一化则控制数值尺度,帮助几十层甚至上百层网络稳定工作。
你可以把残差连接想成修订文档时保留原稿:每一层不是把前一层全部推倒重来,而是在原有表示上增补和校正。
七、走出最后一层:从向量变成“下一个 token 的概率”
经过所有 Transformer 块后,最后一个位置得到一条包含上下文信息的向量。模型再通过输出层(常称 LM Head)把它投影到整个词表,得到每个候选 token 的原始分数,也就是 logits。
接下来通常会经历:
- 根据温度(temperature)调整 logits 的平或尖;
- 通过 softmax 得到概率分布;
- 可选地用 Top-k 或 Top-p 筛选候选,并重新归一化;
- 按策略选择一个 token。
温度低,高概率候选更占优势,回答通常更稳定;温度高,低概率候选更容易被选中,回答可能更有变化,也更容易跑偏。贪心解码则直接选择最高分 token。
重要的是:模型通常不是先写好整篇答案再逐字显示。它更像即兴接龙,每生成一个 token,就把它追加到序列末尾,再预测下一个。
问题 → “答” → “案” → “是” → “5” → “个” → “。” → <结束>
因此,前面一个看似微小的选择,可能改变后续整条生成路线。这也是同一个问题多问几次,答案可能略有不同的原因之一。
八、真正上线时:Prefill、Decode 与 KV Cache
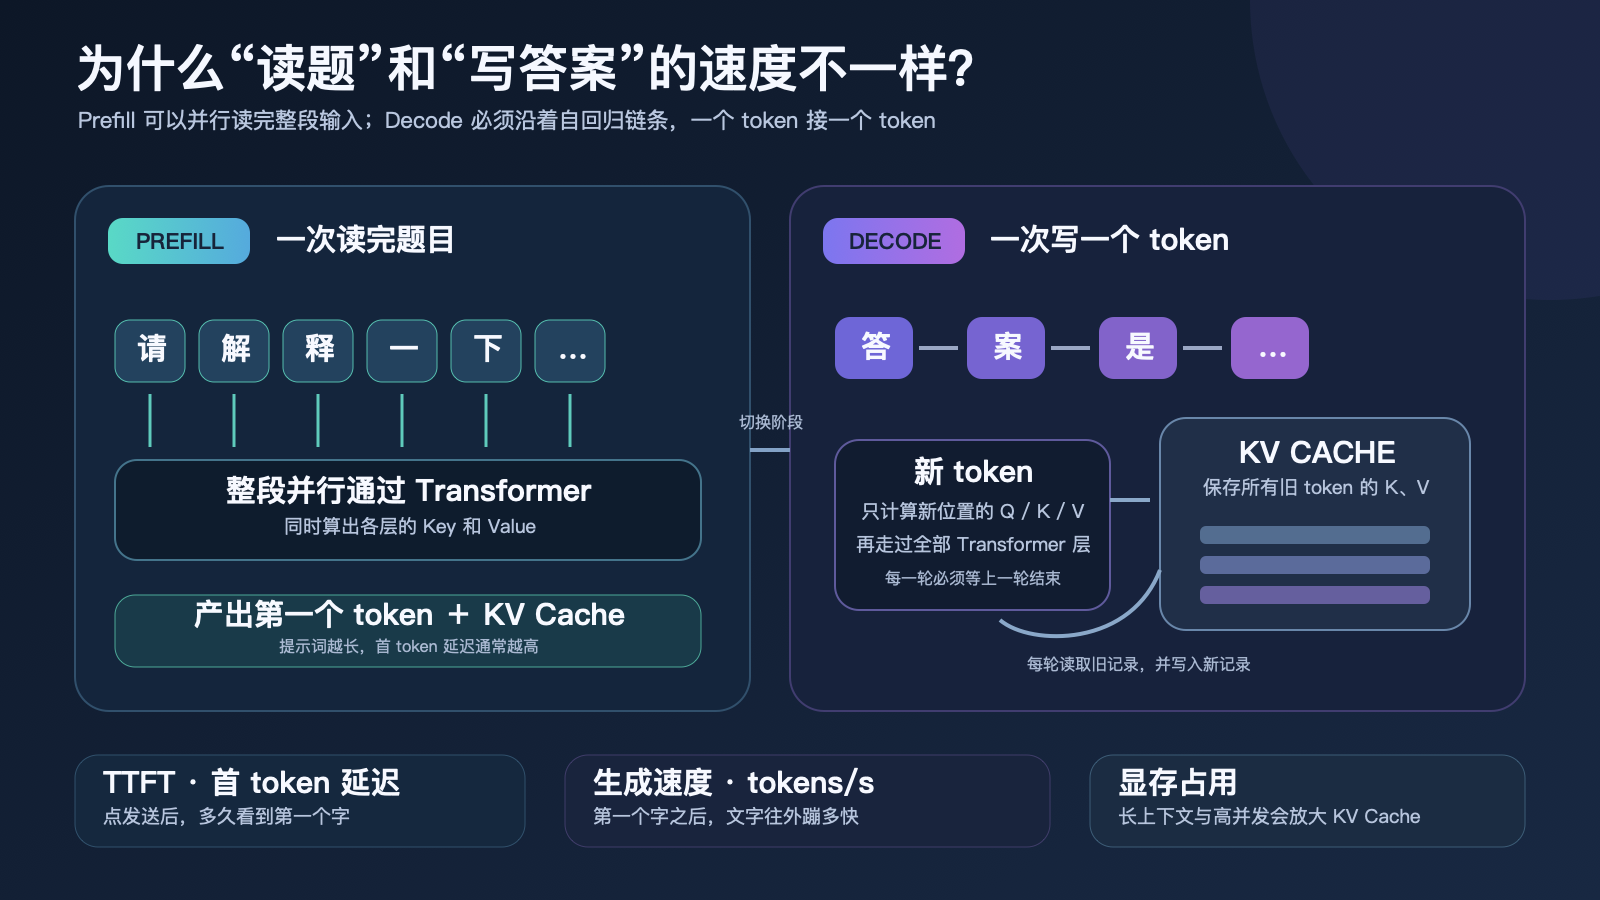
如果每生成一个新 token,都把之前几千个 token 从头算一遍,成本会非常高。现代推理系统通常把过程分成两个阶段。
1. Prefill:一次读完题目
Prefill(预填充)阶段会并行处理整段输入,计算每一层中所有输入 token 的表示,并把注意力需要的 Key、Value 保存起来。
提示词越长,Prefill 通常越耗时。用户感受到的“点发送后,多久出现第一个字”,常用 TTFT(Time to First Token,首 token 延迟)衡量。
2. Decode:一次生成一个 token
进入 Decode(解码)阶段后,每轮只处理刚生成的那个新 token。模型仍需让它关注之前的所有 token,但不必重新计算旧 token 的 Key 和 Value,因为它们已经保存在 KV Cache 中。
KV Cache 就像会议记录:新来的人不必让所有参会者重新发言,只要查阅已经整理好的要点,再写入自己的新内容。
它用显存换速度,而且会随着上下文长度、层数、并发请求数增长。长上下文服务的瓶颈因此常常不是“算不动”,而是“显存里放不下足够多的 KV Cache”。vLLM 的 PagedAttention 论文借鉴操作系统的分页思想管理 KV Cache,减少碎片和重复占用,并让服务系统更灵活地批处理请求。
3. 为什么输出不能像输入一样全部并行?
Prefill 时,整段输入已经知道,所以不同位置可以并行计算;Decode 时,下一个 token 依赖上一个刚生成的 token,因此存在天然的串行链条:
先有 token 1 → 才知道 token 2 的条件 → 才能生成 token 2 → ……
这就是为什么“读一大段文字”与“写一大段文字”的性能特征不同。前者更容易并行,后者通常受逐 token 延迟影响。
九、推理模型究竟怎样“多想一会儿”?
现在把“计算推理”与“逻辑推理”重新接起来。
普通聊天模型遇到复杂题目,也可能直接生成步骤;推理模型则往往经过专门的后训练,使它更愿意在给最终答案前做这些动作:
- 把大问题拆成小问题;
- 写出中间变量或假设;
- 尝试一条路线;
- 发现矛盾后回退;
- 用另一种方法复核;
- 最后压缩成面向用户的答案。
从底层看,这些“思考步骤”仍然是 token 序列。每一个推理 token 都要通过前面讲过的完整 Transformer 流程,再成为后一个 token 的上下文。
这带来一个直观结论:允许模型使用更多测试时计算量,往往能给复杂问题更多搜索和自检机会,但不保证一定正确。 生成得更长也可能是在更长时间里坚持一个错误前提。
还要区分三种东西:
- 内部隐藏状态:每一层中的高维向量,人通常看不到,也不能直接当作自然语言思想。
- 中间推理 token:模型为解决问题生成的步骤,产品可以选择展示、隐藏或摘要。
- 最终答案 token:最终呈现给用户的内容。
所以,“没有展示思维过程”不代表模型只算了一步;反过来,一段写得很像人类草稿的推理文字,也不是正确性的证明。
十、模型调用搜索、代码或数据库时,发生了什么?
大模型本身只负责生成 token。所谓“会联网”“会运行代码”,通常是模型与外部系统合作:
- 模型根据上下文生成一个结构化的工具调用,例如搜索关键词或函数参数;
- 外部程序真正执行搜索、代码或数据库查询;
- 执行结果被转换成文本或其他 token,追加回上下文;
- 模型再次进行 Prefill/Decode,依据新信息回答。
检索增强生成(RAG)也类似:系统先从外部知识库找出相关片段,再把片段连同问题一起交给模型。
因此工具可以提供更新、更精确的数据,但模型仍可能选错工具、写错参数、误读结果。可靠系统通常还会加入权限控制、格式校验、执行隔离和结果验证。
十一、今天的推理系统为什么能跑得更快?
Transformer 主干没有消失,工程师主要从“少搬数据、少占显存、少做重复计算、让更多请求一起跑”入手。
| 技术 | 小白版解释 | 主要收益 | 代价或限制 |
|---|---|---|---|
| KV Cache | 把旧 token 的 K、V 当会议记录保存 | 避免逐轮重算历史 | 长上下文会大量占用显存 |
| FlashAttention | 分块在更快的片上存储中完成注意力 | 减少显存读写,结果仍是精确注意力 | 依赖合适的硬件与内核实现 |
| 连续批处理 | 谁准备好就插入批次,不等整批人一起结束 | 提高 GPU 利用率和吞吐 | 调度更复杂 |
| PagedAttention | 像操作系统分页一样管理 KV Cache | 减少碎片,容纳更多并发 | 引入页表和调度机制 |
| 量化 | 用 8 位或 4 位等低精度表示权重/激活 | 减少显存和带宽,常能提速 | 过度压缩会损害质量 |
| 推测解码 | 小模型先打草稿,大模型一次审核多个 token | 减少大模型串行轮数 | 草稿命中率低时收益有限 |
| MoE | 每个 token 只找少数专家处理 | 大参数容量、较少激活计算 | 路由、通信和负载均衡更难 |
FlashAttention的关键洞见是:注意力慢,不只因为乘法多,还因为 GPU 不同层级存储器之间搬数据很贵;它通过分块计算减少高带宽显存与片上 SRAM 之间的读写。SmoothQuant则展示了如何把 LLM 的权重和激活量化到 INT8,在尽量保持精度的同时降低内存和计算成本。
推测解码更像“实习生起草、专家批改”:较小的草稿模型先猜多个 token,大模型并行验证;接受的草稿可以一次向前推进多步。原始研究表明,在满足相应采样规则时,它可以加速生成而不改变目标模型的输出分布,见《Fast Inference from Transformers via Speculative Decoding》。
十二、速度和成本到底由什么决定?
可以把影响因素分成五组:
- 模型本身:参数量、层数、隐藏维度、注意力结构、MoE 激活专家数。
- 输入输出长度:输入越长,Prefill 越重;输出越长,串行 Decode 轮数越多。
- 数值精度:FP16/BF16、INT8、INT4 等会影响显存、带宽、速度和质量。
- 硬件与并行:GPU/加速器的算力、显存带宽、机器间通信和并行策略。
- 服务调度:批处理大小、KV Cache 管理、请求优先级、是否使用推测解码等。
两个常见指标也要分开看:
- 延迟(latency):一个用户等多久;
- 吞吐(throughput):整个系统每秒为所有用户生成多少 token。
一次塞入更多请求,吞吐可能提高,但单个用户未必更快。就像公交车载客效率更高,却不等于每个人都更早到家。
十三、几个最容易产生的误解
误解 1:模型在数据库里找到一段原文,再复制出来
模型参数更像从训练数据中学到的统计结构,而不是可以按地址读取的文章仓库。它确实可能记住并复现某些训练片段,但大多数生成是根据上下文逐 token 组合出来的。
误解 2:注意力权重就是模型完整的思考过程
注意力权重只描述某个模块在某层、某个头上的信息混合比例。模型的计算还包括多层残差、前馈网络、归一化和非线性变换。单看一张注意力热力图,不能完整解释模型为何得出答案。
误解 3:模型说得流畅,就一定理解并且正确
训练目标首先鼓励“生成在上下文中合理的下一个 token”。事实正确性、逻辑有效性和语言流畅度有关联,却不是同一件事。一个错误结论也可以被写得非常顺畅。
误解 4:温度调到 0,任何时候都会得到字节级完全相同的答案
贪心选择会显著减少随机性,但不同硬件、并行策略、数值精度、模型版本或相同分数的处理方式仍可能造成差异。工程上的“近似确定”不等于所有环境下绝对一致。
误解 5:上下文越长,模型记得越牢
上下文窗口表示“允许放进去多少”,不表示模型会同等重视每个位置。长上下文还会增加 Prefill 成本、KV Cache 占用和检索难度。
十四、把整条链路再压缩成 12 句话
- 系统把指令、历史对话、用户问题和工具结果拼成上下文。
- Tokenizer 把文本切成 token,并转换为整数 ID。
- 嵌入层把 ID 变成高维向量。
- 位置编码告诉模型 token 的顺序和距离。
- 自注意力用 Q、K、V 计算每个位置该关注哪些历史信息。
- 因果遮罩阻止模型在预测时偷看未来。
- 多头注意力从不同角度并行组合信息。
- 前馈网络对每个位置的表示做进一步变换;MoE 模型只激活部分专家。
- 残差连接和归一化让信息在深层网络中稳定传递。
- 最后一层把表示映射成整个词表的 logits,再转成概率并选出一个 token。
- 新 token 被接回上下文,模型利用 KV Cache 继续逐 token 生成。
- 推理模型的“多想一会儿”,本质上是用更多中间步骤、验证或搜索换取更大的解题机会。
结语:复杂智能,建立在重复的下一步预测之上
Transformer 最迷人的地方,是它把一个简单目标推到了惊人的规模:预测下一个 token。
单独看一次预测,它只是矩阵运算和概率分布;把它放进数十亿参数、海量训练数据、多层注意力、工具系统和成千上万次连续生成中,我们便看到了摘要、代码、对话与推理。
但也正因为如此,我们应同时保留两种认识:一方面,它不只是“随机拼字”,因为每个 token 都经过了对整个可见上下文的深层计算;另一方面,它也不是天然可靠的全知大脑,因为“最可能的下一步”并不自动等于“真实而正确的下一步”。
理解这条推理流水线,既能帮助我们更好地使用大模型,也能更清醒地判断它的能力边界。
参考资料
- Vaswani, A. et al. Attention Is All You Need, 2017.
- Su, J. et al. RoFormer: Enhanced Transformer with Rotary Position Embedding, 2021.
- Fedus, W., Zoph, B., Shazeer, N. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity, 2021.
- Dao, T. et al. FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness, 2022.
- Leviathan, Y., Kalman, M., Matias, Y. Fast Inference from Transformers via Speculative Decoding, 2022.
- Xiao, G. et al. SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, 2022.
- Kwon, W. et al. Efficient Memory Management for Large Language Model Serving with PagedAttention, 2023.
- DeepSeek-AI et al. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025.
注:文中概率、分词结果和若干比喻均为教学示意;具体模型的词表、层数、归一化顺序、位置编码、注意力结构和解码策略会有所不同。
评论